VBAで関数コールツリーを使いこなす【2025年ExcelFansアドベントカレンダー】
~~~未知マクロの読解と、自作設計の破綻防止を「呼出し構造」で支ええる~~~
Copyright © 2025 LWP 山中 一弘 本資料は、出典を明記いただければ、商用・非商用を問わず、ご自由に複製・改変・再配布していただけます。なお、著作権表示は改変せず、そのまま記載してご利用くださいますようお願いいたします。
記事要約
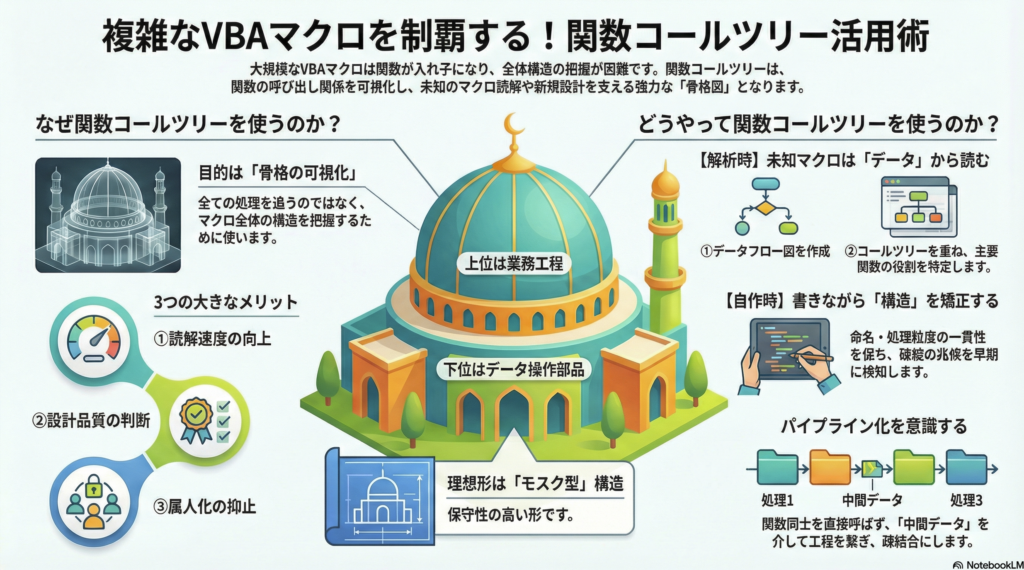
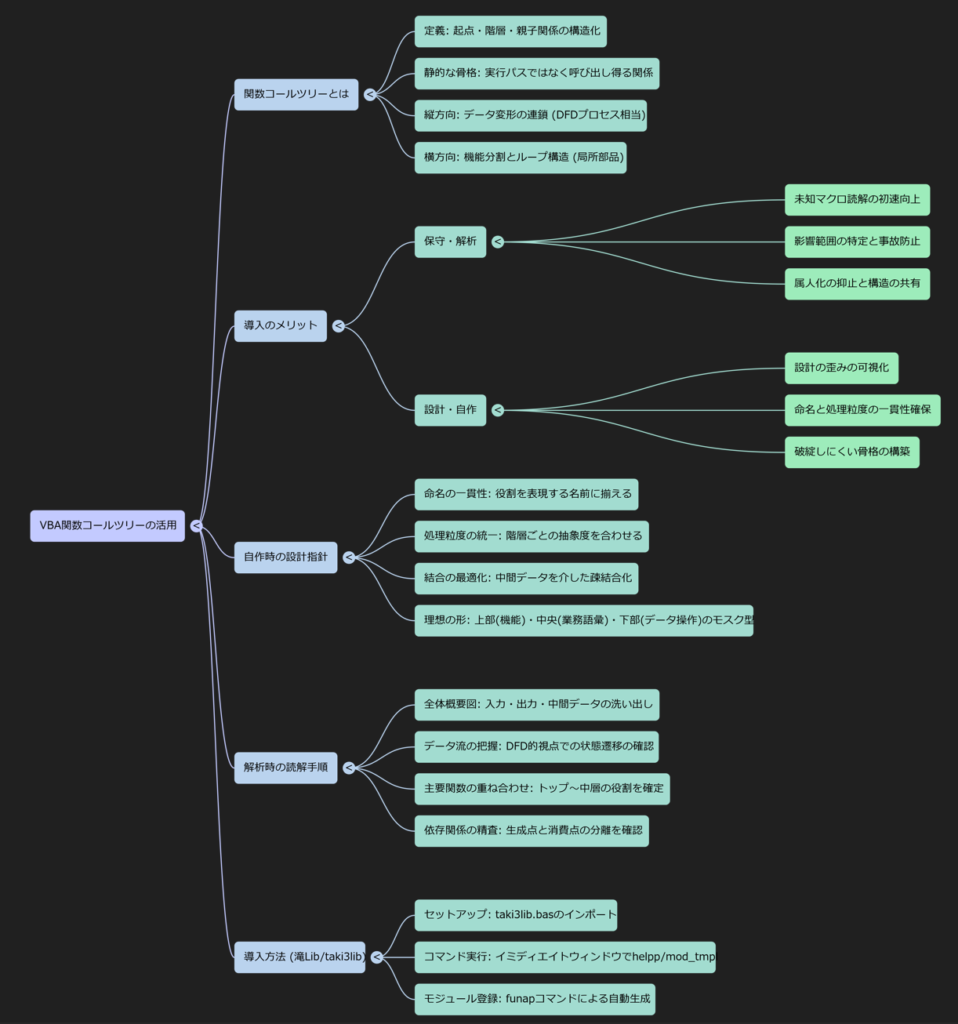
VBAの業務マクロは、関数分割が進み、入れ子と例外が増えるほど全体構造の把握が難しくなります。特に、他人が作った既存マクロの解析では「どこから追えばよいか」が分からず、理解の初速が落ち、改修リスクが跳ね上がります。本記事は、起点関数から呼出し関係を階層表示する「関数コールツリー」を用いて、未知マクロの構造を短時間で可視化し、設計と保守の判断を支える方法を解説します。
自作時には命名と処理粒度の不揃い、呼出し関係の不自然さを早期に検知し、破綻しにくい骨格へ寄せるために使います。解析時には、ノート上の全体概要図と主要データ流にコールツリーを重ね、上位関数の役割とデータの受け渡しを先に確定させる読み方を採ります。
さらに、滝Lib(taki3lib)を使い、イミディエイトウィンドウから1行実行でコールツリー関数群を新規モジュールとして登録する導入手順を提示し、属人化しない運用SOP(Standard Operating Procedure)として整えます。
本記事の対象とゴール
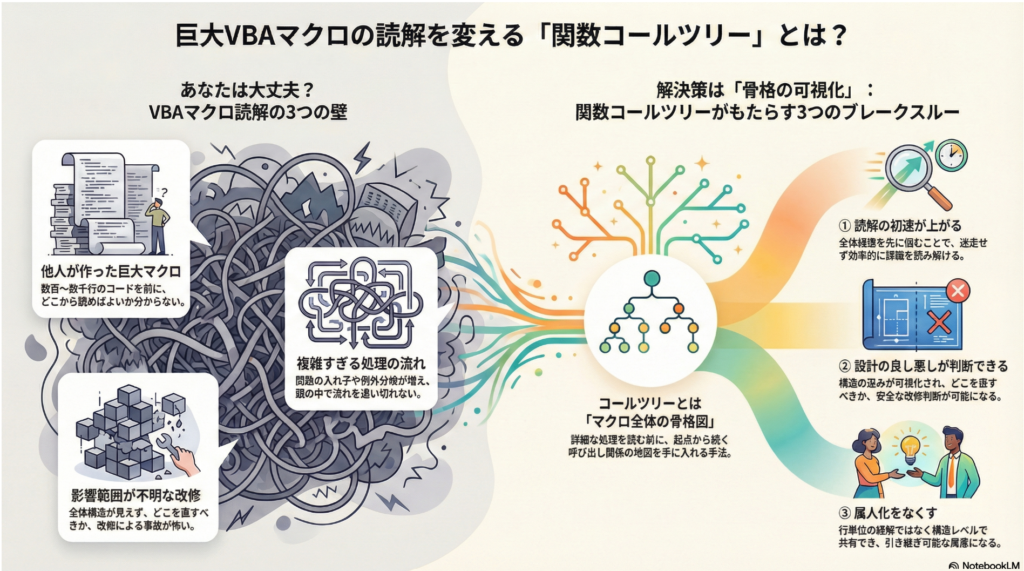
本記事は、VBAマクロの構造把握と設計判断に課題を感じている実務者に向けて、「関数コールツリー」という可視化手法を、読み方・使い方・判断へのつなげ方まで含めて整理することを目的とします。VBAの業務マクロは、規模が大きくなるにつれて処理が分岐し、関数呼び出しが入れ子になり、例外対応が積み重なります。その結果、コードの一部は読めても、全体として何をしているのかが把握しづらい状態に陥りやすくなります。本章では、まず想定読者像を明確にし、次に記事を通じて得られる具体的な成果を整理します。最後に、以降の章全体を貫く結論として、コールツリーの位置づけを先に示します。
構造化言語における関数コールツリーは、縦と横で別の意味を担います。縦方向は、データが入力から出力へ向かってどのように形を変え、どの地点で確定し、次の工程へ受け渡されるかという「データ変形の連鎖」を表し、DFDのプロセスとデータフローに相当します。したがって縦は、単なる処理順序ではなく、データの状態遷移(形式・粒度・品質の変化)を追跡できることが本質であり、縦に並ぶ節点(関数群)は「この入力をこういう出力にする」という変換契約で定義されます。
一方で横方向は、同じ縦の地点(同じデータ状態・同じ変換契約)の内部をどう分割して実装するか、という「機能分割」を表します。ここでいう機能分割は工程を増やすことではなく、その工程の内部処理を、検証・正規化・突合・集計・例外処理などの局所部品に分解し、見通しと再利用性を確保するための分割です。特にループ(全体→個別の反復処理)は横側の代表例で、縦の工程としては「集合を処理して次のデータ形にする」なのに対し、横では「1件(1行・1レコード・1要素)に対する処理」を切り出し、反復の枠(全体制御)と個別処理(1件処理)を分離して表現します。
ここに「全体構成図にDFDをかぶせる」という操作を加えると、設計から実装までが過不足なく合致します。まず、モノ(データ実体)とその関連を記述する全体構成図が、扱う世界の構造=データ構造を与えます。その上にDFDを重ねることで、その構造物の内部をデータがどう流れ、どこで変形し、どこで確定するか(流れと状態遷移)が定義されます。そして、この二つの構造(モノと関連/流れと変形)を土台に関数コールツリーを構築すると、縦はDFDどおりのデータ変形の連鎖に、横は各地点の機能分割とループ構造に一致します。結果として、全体構成図(モノと関連)+DFD(流れと変形)+コールツリー(構造を反映した実装)が同一の座標系で噛み合い、「プログラミング=データ構造+アルゴリズム」を、構造化言語の作法としてそのまま実装に落とし込める、という位置づけが得られます。
想定読者はVBAマクロ実務者
本記事の想定読者は、業務でVBAマクロを扱っている実務者です。学習目的のサンプルコードではなく、現場で運用されている既存マクロを保守・改修する場面を主に想定します。
具体的には、次のような状況に直面している人を対象とします。
・既存のVBAマクロを保守・改修する立場にある
・自分以外の人が作成したマクロを引き継いだ経験がある
・数百行〜数千行規模のコードを前にして、どこから読めばよいか分からないと感じたことがある
・処理の入れ子や例外分岐が増え、処理の流れを頭の中で追い切れなくなった経験がある
重要なのは、VBAの文法が分からない人を対象としていない点です。If文やFor文、Sub/Functionの基本が分かり、コードは書けるが、他人のコードや巨大なコードを読む段階で躓いている実務者を想定します。
また本記事は、新規にきれいなマクロを書く方法だけを扱うものではありません。むしろ比重を置くのは、既に存在する未知のマクロを短時間で把握する場面です。自作・他作を問わず、既にあるものをどう読むか、という視点を重視します。
本記事で得られること(読解速度/設計判断/属人化抑止)
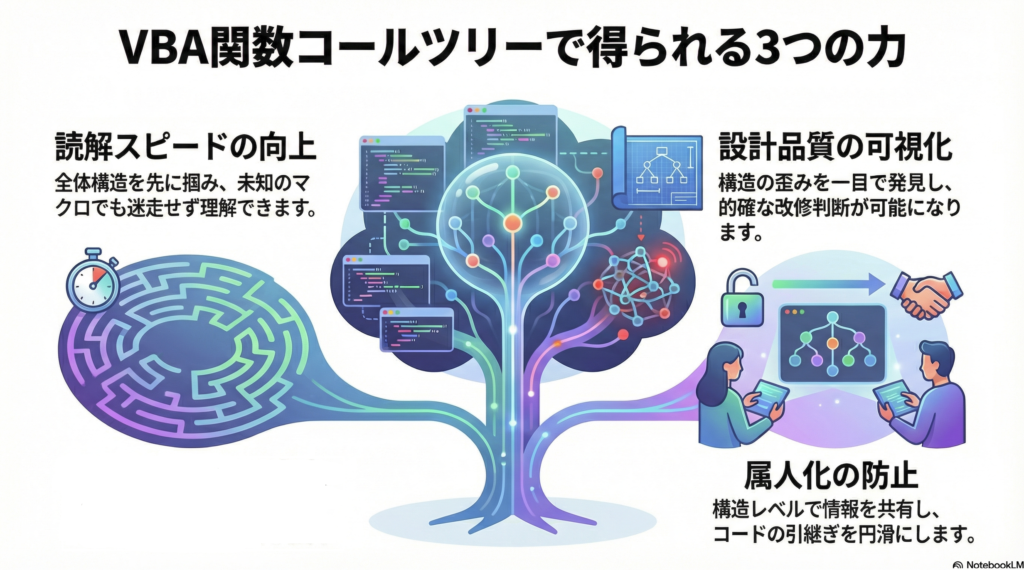
本記事を通して得られる成果は、大きく三つです。
第一に、マクロ読解の初速が上がります。関数コールツリーを使うことで、どの関数が起点で、どこに処理が分岐していくのかを一枚の構造として把握できるようになります。これにより、コードを上から順に追う読み方から脱却し、全体構造を掴んだうえで詳細に降りていく読み方が可能になります。未知マクロに対する理解の初速が改善されます。
第二に、設計の良し悪しを判断できるようになります。コールツリーは単なる一覧ではありません。呼び出し構造を俯瞰することで、処理粒度が不揃いな関数、役割が曖昧な中継関数、不自然に深い入れ子、例外処理が構造を歪めている箇所といった設計上の歪みが可視化されます。これにより、どこを直すべきか、どこには触らない方がよいかという改修判断の根拠を持てます。
第三に、属人化を抑止する読み方・運用に接続できます。属人化の本質的な問題は、書いた人しか分からないこと自体ではなく、構造を共有できない状態が続くことです。本記事では、コールツリーをノート上の全体概要図や主要データの流れと重ねて読む方法を扱い、行単位の理解ではなく構造レベルで理解・説明・引き継ぎができる状態を目指します。
先に結論:コールツリーは「骨格の可視化」である
本記事の結論を先に示します。コールツリーとは、処理の詳細を理解するための道具ではありません。マクロ全体の骨格を可視化するための道具です。
VBAマクロを読む際に重要なのは、最初から全ての処理内容を理解しようとしないことです。それより先に、起点となる関数はどれか、上位関数はどのような役割を持っているか、処理はどの段階で分岐しているか、といった構造的な骨格を押さえる必要があります。
コールツリーは、この骨格を短時間で確定させるための手段です。骨格が定まれば、個々の処理の意味は後から追えます。逆に骨格が見えないまま詳細を読み始めると、理解は途中で破綻します。
昔の話:関数コールツリーとは何か
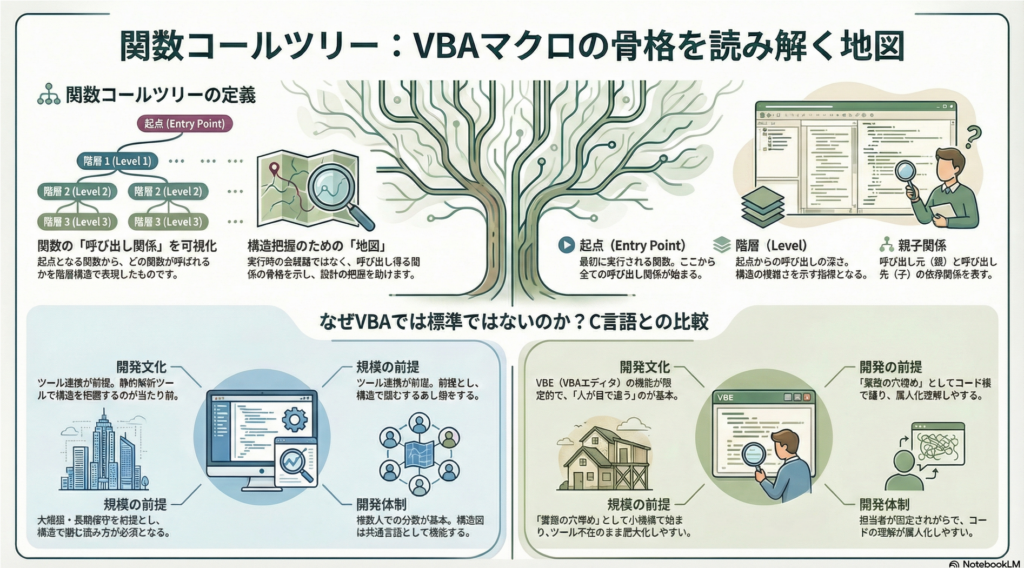
この章では、関数コールツリーを「何を表すものか」を定義し、なぜC言語の世界では昔から当たり前に存在したのに、VBAでは標準にならなかったのかを整理します。狙いは、コールツリーを単なる便利ツールではなく、開発文化と規模の前提が作った必然として理解し、VBAの現場に持ち込む意味を明確にすることです。
2.1 関数コールツリーの定義(起点・階層・親子関係)
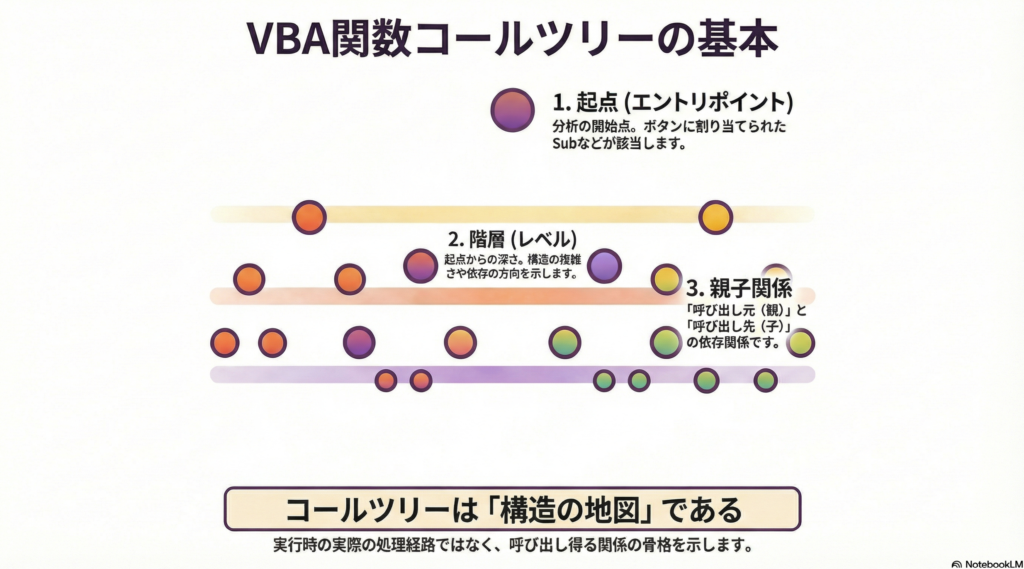
関数コールツリーとは、あるプログラムにおける「関数(またはプロシージャ)の呼び出し関係」を、起点から辿って階層構造として表示したものです。重要なのは、ソースコードを上から順に並べるのではなく、「呼ばれる順」「依存の向き」に従って構造を組み直す点です。
定義として、最低限押さえる要素は三つです。
第一に、起点(エントリポイント)です。起点とは、読み始めるべき関数のことです。C言語であれば main、VBAであればボタンに割り当てられたSub、Workbook_Open、Auto_Open、あるいは運用上の起点となるSubなどが該当します。コールツリーは、この起点を定めない限り作れません。なぜなら、呼び出し関係は全体を無差別に並べても意味が薄く、「どこから実行されるのか」が確定して初めて、依存関係が読める形になるからです。
第二に、階層(レベル)です。起点から直接呼ばれる関数を第1階層、その関数が呼ぶ関数を第2階層、というように深さで整理します。この深さは、単なる見た目ではなく、「上位の役割が下位の部品に依存している」という設計の方向を表します。階層が深いほど悪い、という単純な話ではありません。ただし、深さが増えるほど、全体把握は難しくなり、例外や分岐の影響が強くなります。したがって、階層は構造の複雑さを観察するための重要な指標になります。
第三に、親子関係です。コールツリーにおける親は「呼び出し元」、子は「呼び出し先」です。これは処理の順番そのものではなく、依存の関係です。親は子を知らないと動けないが、子は親を知らなくても成立する、という非対称性が含まれます。親子関係が明確になると、上位関数は役割、下位関数は部品という設計の基本が、そのまま読める形で出てきます。
ここで誤解しやすい点を一つ押さえます。関数コールツリーは、実行時の「実際の経路」をそのまま示すものではありません。条件分岐や例外処理がある以上、実行パスは入力や状態で変わります。コールツリーが示すのは、静的に見た「呼び出し得る関係の骨格」です。したがって、コールツリーはトレースログの代替ではなく、構造把握のための地図だと捉えるのが正確です。
2.2 C言語では昔からあった理由(ツール文化と規模の前提)
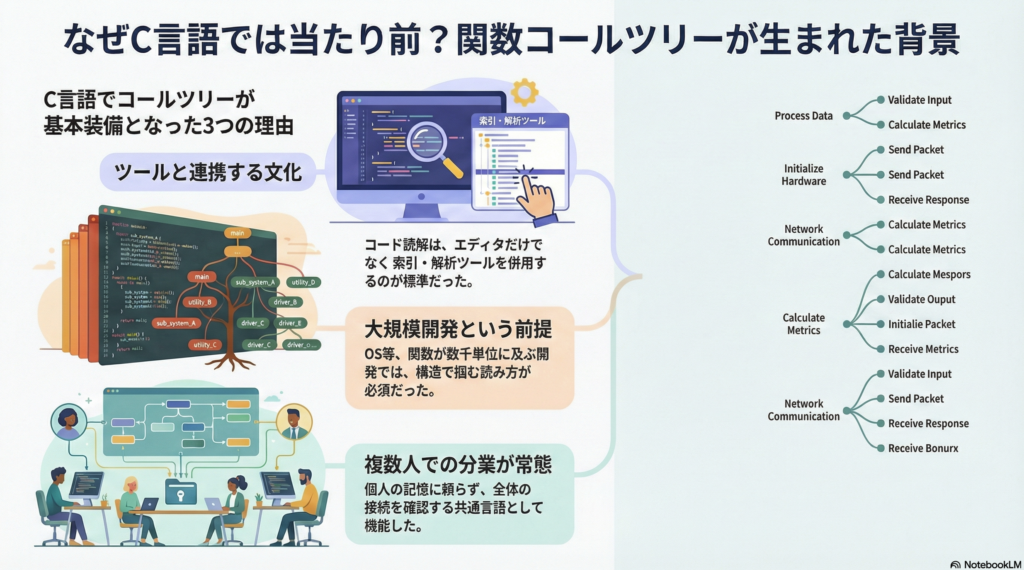
C言語の世界では、関数コールツリーやクロスリファレンスは昔から当たり前に存在していました。理由は、言語の優劣ではなく、文化と前提条件にあります。
第一に、ツール文化の前提が違います。C言語は、コンパイラ、リンカ、デバッガ、静的解析器、ドキュメント生成など、「周辺ツールと一緒に使う」ことが前提の言語です。ソースコードはテキストであり、grepやctagsのような索引化ツールと相性が良く、参照関係や呼び出し関係を解析して一覧化する文化が早期に成立しました。つまり、コードを読む行為が、エディタ単体ではなく、索引と解析の道具を併用する形で標準化していたのです。
第二に、規模の前提が違います。C言語は、最初から「大きくなる」ことを前提に使われやすい言語です。OS、ミドルウェア、組み込み、基盤ライブラリなど、複数人で長期間保守する用途が多く、関数は数百、数千という単位で増えます。この規模になると、読み方の基本が「線形に読む」から「構造で掴む」に変わります。関数コールツリーは、この規模の前提に対する必然の道具です。
第三に、分業の前提が違います。複数人開発が前提になると、誰かが書いた部分を別の誰かが読む状況が常態になります。すると、コードの理解を個人の記憶や勘に依存させられません。索引と構造図が必要になります。コールツリーは、個々の関数の中身を読む前に、全体の接続を確認するための共通言語になります。
このように、C言語でコールツリーが昔から存在したのは、コードが大規模で、分業で、長期保守され、周辺ツールと一体で運用される、という前提が強かったからです。コールツリーは高度な道具ではなく、その前提に対する基本装備です。
2.3 なぜVBAには標準でないのか(VBEの限界と現場ギャップ)
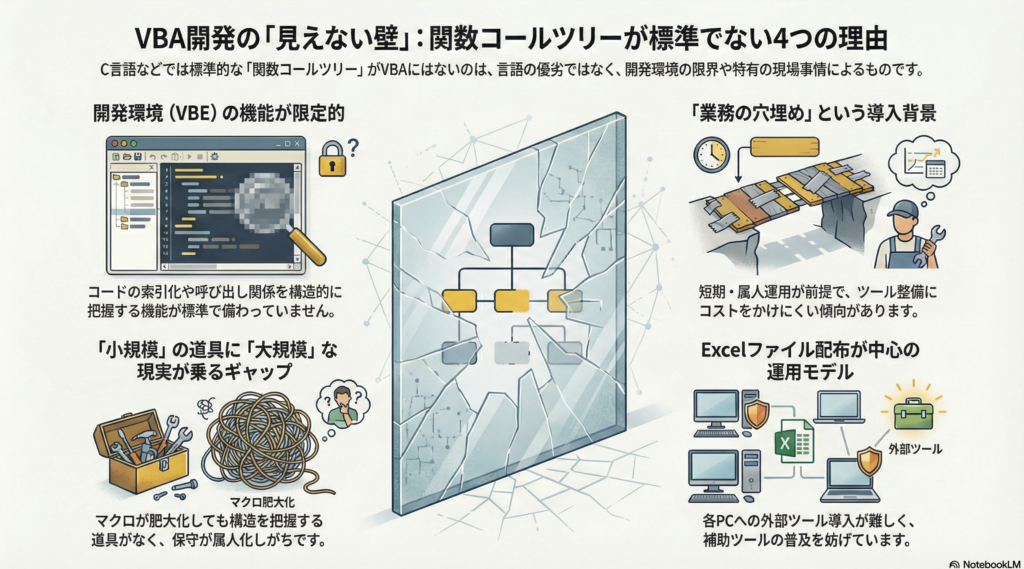
では、なぜVBAには標準でコールツリーがありません。これも能力の問題ではなく、環境と現場のギャップによるものです。
第一に、VBE(VBAエディタ)の限界です。VBEは、現代的なIDEに比べると、コード索引や静的解析の機能が弱く、参照関係を横断的に把握する機能が標準で備わっていません。検索はできても、呼び出し関係を構造として組み立てる機能は基本的にありません。したがって、VBAの世界では「人が目で追う」前提で運用が続きやすくなります。
第二に、VBAが置かれる現場の前提です。VBAは、基盤開発というより「業務の穴埋め」として導入されることが多く、短期で作られ、担当者が固定され、ドキュメントやツール整備にコストがかけられない状況が一般的です。結果として、規模が大きくなってもツール文化が育たず、構造可視化が後回しになります。コールツリーが標準化されない土壌がここにあります。
第三に、規模と品質のアンバランスです。VBAは小さく作られる前提で始まります。しかし現場では、業務が複雑で例外が多く、マクロが肥大化しやすい。つまり、「小規模の道具」として導入された環境に、「大規模の現実」が乗ってしまうことが起きます。このときに必要になるのが構造把握の道具ですが、標準装備がないため、理解と保守が属人的になりやすい、というギャップが発生します。
第四に、配布と運用の問題です。C言語のツール群は、開発環境にインストールして使うことが前提ですが、VBAの現場は「Excelファイルを配布して動かす」ことが中心です。環境が統一されておらず、個々のPCに外部ツールを導入できないことも多い。そのため、コールツリー生成のような補助ツールが普及しにくいという現実があります。
以上をまとめると、VBAにコールツリーが標準でない理由は、VBEの索引・解析機能が限定的であること、VBAが置かれる現場が短期・属人・ツール整備不足になりやすいこと、そして小規模前提の環境に大規模化した業務ロジックが乗るギャップがあることにあります。
このギャップを埋めるのが、本記事で扱う「コールツリーを自前で生成し、読み方と運用SOPまで整える」というアプローチです。次章では、VBAの現場で具体的に何が起きているのか、読解が破綻する典型パターンを分解し、コールツリーが効く理由を構造として説明します。
関数コールツリーがあると何がうれしいか
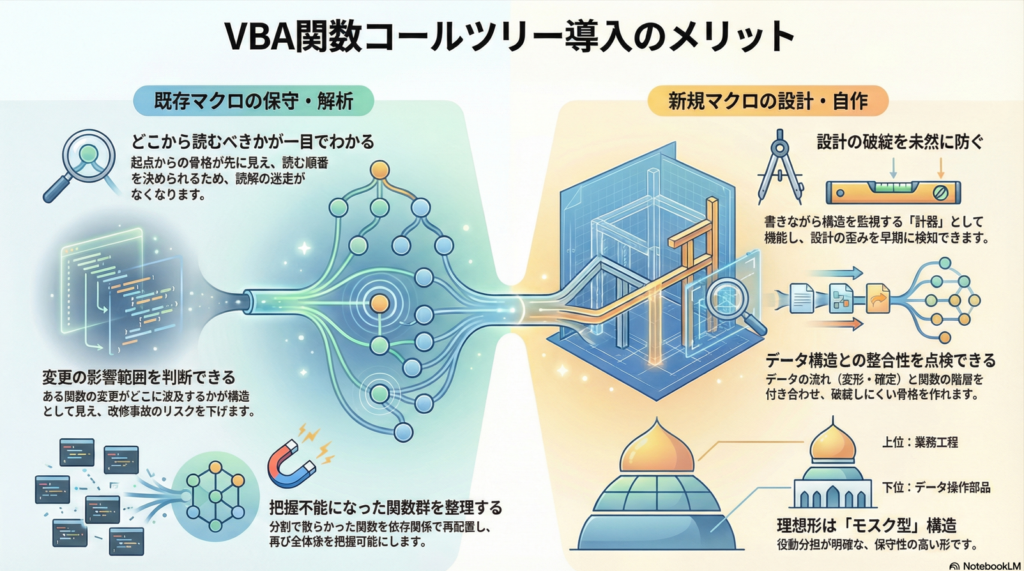
この章では、関数コールツリーを導入すると何が改善されるのかを、実務上の効果として整理します。ポイントは「読むのが楽になる」という感想ではなく、保守・解析と設計・自作の両面で、どの判断が可能になり、どのリスクが下がるのかを言語化することです。
3.1 2つの観点(保守・解析/設計・自作)
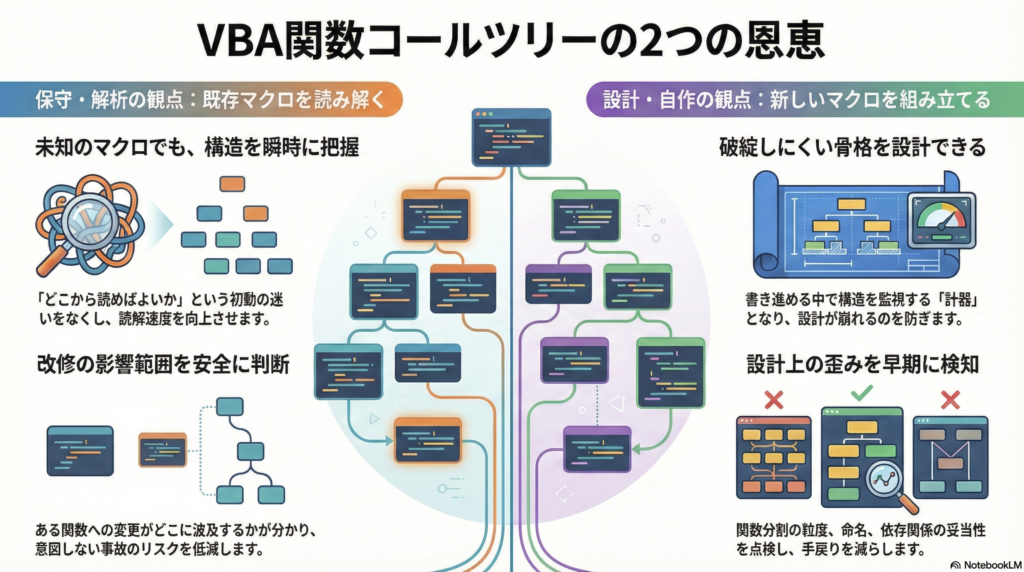
関数コールツリーの効き方は、大きく二つの観点に分かれます。保守・解析の観点と、設計・自作の観点です。
保守・解析の観点では、既存マクロを引き継いだときに、全体構造を短時間で掴み、改修範囲と影響範囲を判断するために使います。ここでの主な課題は、どこから読めばよいか分からない、全体が見えないまま改修に入って事故る、という問題です。コールツリーは、この初動の迷走を抑えます。
設計・自作の観点では、新規作成や改修設計の段階で、関数分割の粒度、命名、依存関係の妥当性を点検し、破綻しにくい骨格に寄せるために使います。ここでの主な課題は、書き進めるほど構造が見えなくなり、入れ子と例外が増えて設計が崩れる、という問題です。コールツリーは、書きながら構造を監視する計器になります。
同じ図を使っても、目的が違えば読み方が変わります。本章では、この二つを混ぜずに、効果を順に説明します。
3.2 既存の知らないマクロの構造が見える
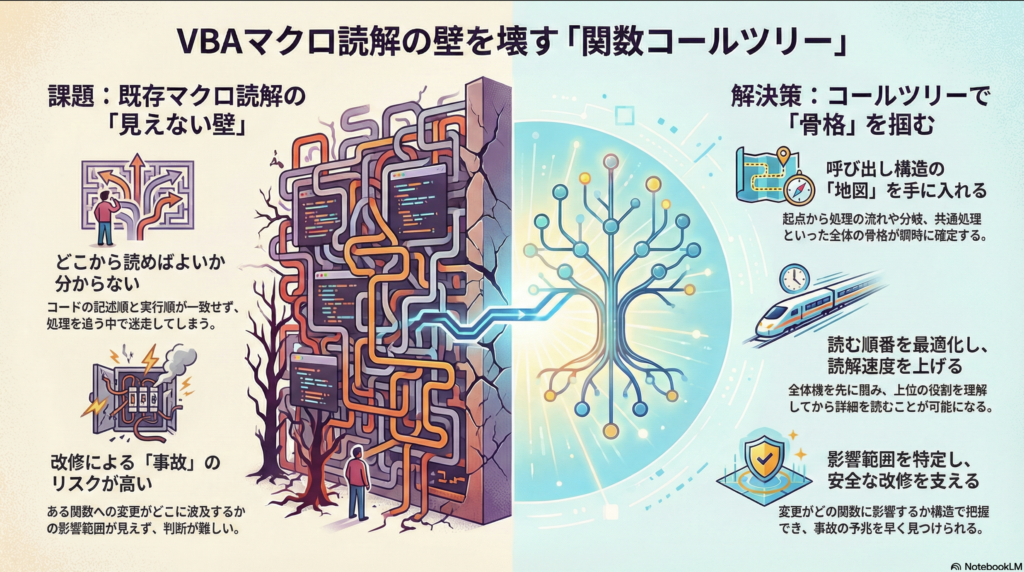
既存マクロの解析で最もきついのは、処理の詳細が難しいことではありません。どこから追えばよいかが分からないことです。起点が不明、関連する関数が散在、例外処理が各所に入り、コードの順番と実行の順番が一致しない。この状態で上から読み始めると、重要な分岐を踏み外しやすく、理解が進まないまま時間だけが消えます。
コールツリーがあると、まず起点から見た「呼び出しの骨格」が確定します。上位で何をしているか、どこで分岐し、どこで共通処理に落ちるか、どこにI/Oが集約されているか、といった全体像が先に見えます。これにより、読む順番を決められるようになります。
読む順番とは、単に「上から順に読む」ことではありません。上位の役割を確定し、主要なデータの受け渡しを押さえ、それから下位の実装に降りることです。コールツリーは、その順番を作るための地図になります。結果として、未知マクロの読解速度が上がります。速度が上がるというより、迷走が減ります。
さらに、影響範囲の判断が可能になります。ある関数を変更すると、どの親が呼び、どの子が呼ばれ、どこに波及するかが構造として見えるためです。これは「改修していいかどうか」の判断材料になります。現場では、実装難度よりも「事故る可能性」が最大のコストです。コールツリーは、事故の予兆を早く見つける道具です。
3.3 新規作成時にデータ構造と付き合わせて全体を把握できる
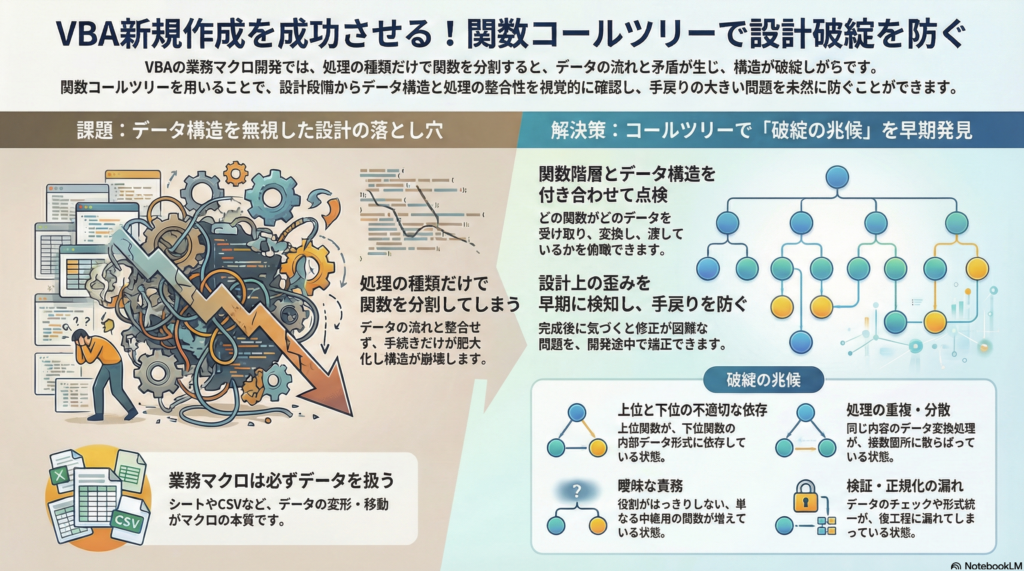
新規作成時にも、コールツリーは効きます。ただし目的は、後から読むためではなく、書いている途中で破綻しないためです。
VBAの業務マクロは、必ずデータ構造を扱います。シート、テーブル、CSV、辞書、配列、集計結果など、何らかのデータが入力され、変形され、出力されます。ここで重要なのは、関数分割を「処理の種類」だけで決めないことです。データの流れと整合して分割する必要があります。
コールツリーがあると、上位関数がどのデータを受け取り、どの形式に変え、どこへ渡しているかを、呼び出し構造として俯瞰できます。つまり、関数の階層とデータ構造を付き合わせて点検できます。これにより、次のような破綻を早期に検知できます。
・上位関数が下位の内部形式に依存している
・同じデータ変換が複数箇所に散っている
・責務が曖昧な中継関数が増えている
・データの正規化や検証が下流に漏れている
これらは、書き終わった後に気づくと手戻りが大きい問題です。コールツリーで書きながら見える化しておけば、途中で骨格を矯正できます。
3.4 Excel/VBAでの「データ構造+アルゴリズム」の捉え直し
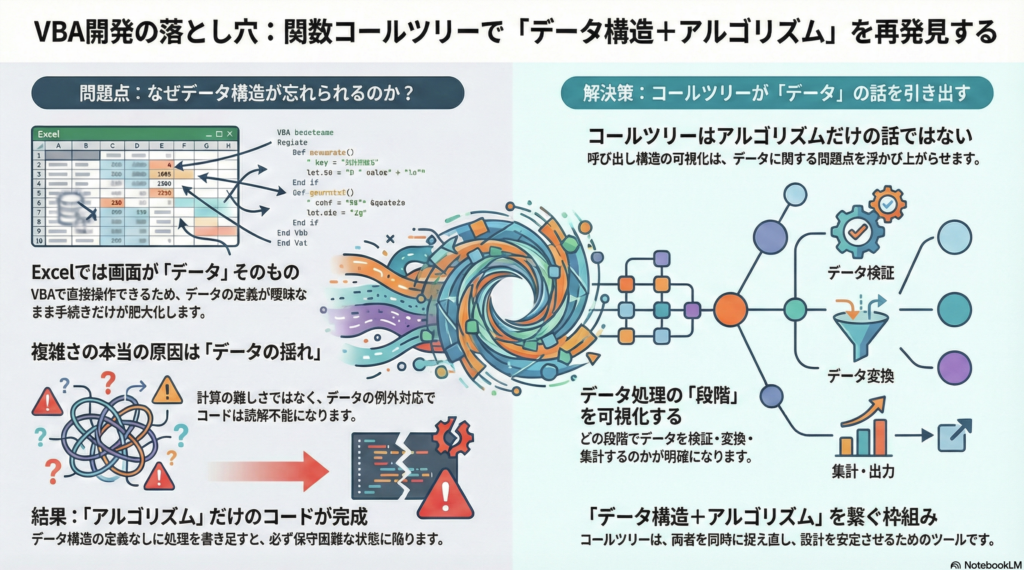
Excel/VBAの現場では、「データ構造」と「アルゴリズム」を分けて考える習慣が弱くなりがちです。理由は単純で、Excelは画面(シート)がデータそのものであり、VBAはそれを直接つまむように操作できるからです。結果として、データの定義が曖昧なまま、手続きだけが肥大化します。
しかし、規模が大きくなると、このやり方は必ず詰まります。なぜなら、業務マクロの複雑さの大半は、計算式の難しさではなく、データの揺れと例外に由来するからです。データの意味、粒度、整合性を定義せずに処理を書き足すほど、例外処理が増え、入れ子が深くなり、全体が読めなくなります。
コールツリーは、アルゴリズムの話だけをしているように見えて、実際にはデータの話を引きずり出します。呼び出し構造が見えると、どの段階でデータを検証し、どの段階で変換し、どの段階で集計するのかが浮かび上がるためです。つまり、コールツリーは「データ構造+アルゴリズム」を同時に捉え直すための枠組みになります。
3.5 上(トップダウン)と下(ボトムアップ)からの俯瞰
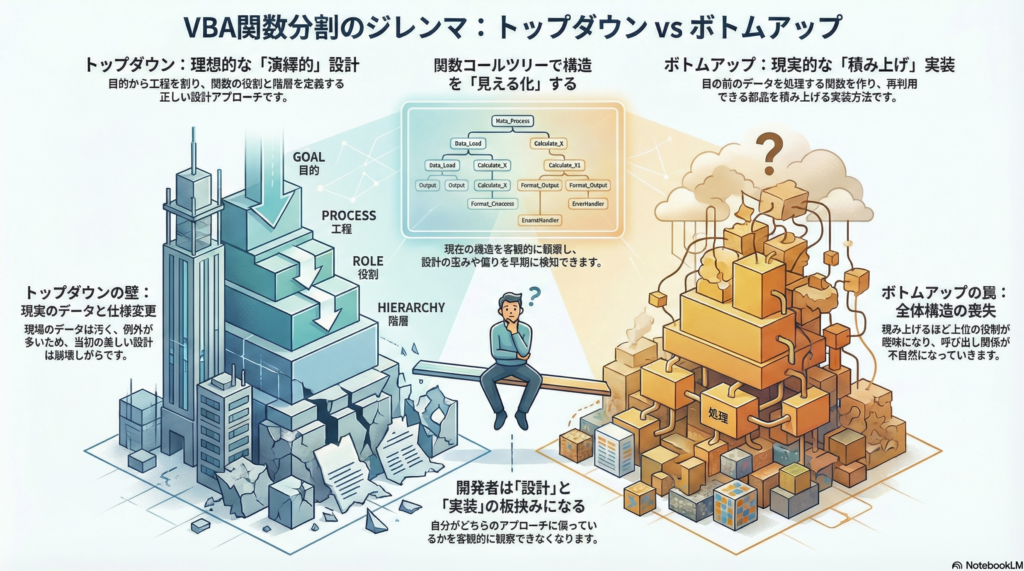
実務で関数分割が難しくなる理由は、技術が難しいからではありません。トップダウンとボトムアップが同時に要求されるからです。
トップダウンでは、目的から工程を割り、役割を定義し、関数の階層を設計します。これは設計として正しい方向です。しかし現場では、入力データが汚い、例外が多い、途中で仕様が変わる、という事情があります。すると、下位で必要になる処理が増え、当初の設計どおりに収まりません。
一方、ボトムアップでは、目の前のデータを処理するための関数を作り、再利用できそうな部品を積み上げます。これは実装として現実的です。しかし積み上げるほど、上位の役割が曖昧になり、呼び出し関係が不自然になり、結局全体が見えなくなります。
この両者の板挟みが、入れ子と分割を難しくします。コールツリーがないと、いま自分がどちらに偏っているかを客観的に観察できません。
この二つの対立軸は、古くから設計方法論として整理されてきました。ボトムアップの代表例としては、マイケル・A・ジャクソンの『Jackson Structured Programming』が挙げられます。処理の流れを現実のデータ構造に沿って組み立てる発想が強い方法論です。ただし同書は入手が難しいため、日本で購入しやすい入門書としては『ずっと受けたかったソフトウェア設計の授業』(飯泉純子・大槻繁)を参照すると、考え方をつかみやすくなります。
一方、トップダウンの代表例としては、ヨードン&コンスタンティンの『Structured Design: Fundamentals of a Discipline of Computer Program and Systems Design』があります。目的から機能を分割し、モジュール階層を設計して責務を明確にする考え方が前面に出ます。こちらも原典は入手しにくいため、日本で購入可能で、構造化の発想を学べる入門書としては『演習で身につくソフトウェア設計入門』などがあります。
「現場では両方が同時に要求される」という状況は、この二つの代表的立場を押さえることで、どこで設計が詰まりやすいかを具体的にイメージしやすくなります。
3.6 演繹で分割しつつ途中で妥当性確認したくなる問題
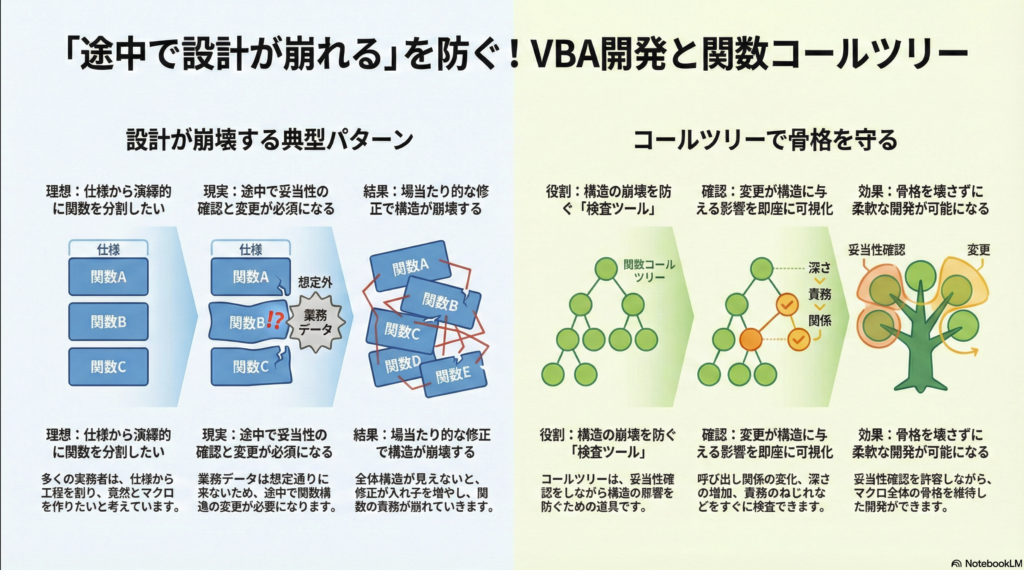
多くの実務者は、演繹的に分割したいと思っています。つまり、仕様から工程を割り、関数を決め、整然と作りたい。しかし実際には、途中で必ず妥当性確認が必要になります。なぜなら、業務データは想定どおりに来ませんし、それができるような関数分割スキルを保有していないことがほとんどです。
このときに起きるのが、設計の途中変更です。入口の検証が不足していた、想定外の値が混じる、例外の優先順位が逆だった、などが発覚し、途中で関数構造を変えたくなります。ところが、構造が見えていないと、変更は場当たり的な追記になり、入れ子が増え、関数の責務が崩れます。
コールツリーは、この「途中で妥当性確認したくなる」現実を前提にしつつ、構造の崩壊を防ぐ道具です。変更した結果、呼び出し関係がどう変わったか、深さが増えたか、責務がねじれていないかを、すぐに検査できます。つまり、妥当性確認を許容しながら、骨格だけは壊さない運用が可能になります。
3.7 関数が増えるほど把握不能になるという実務の痛点
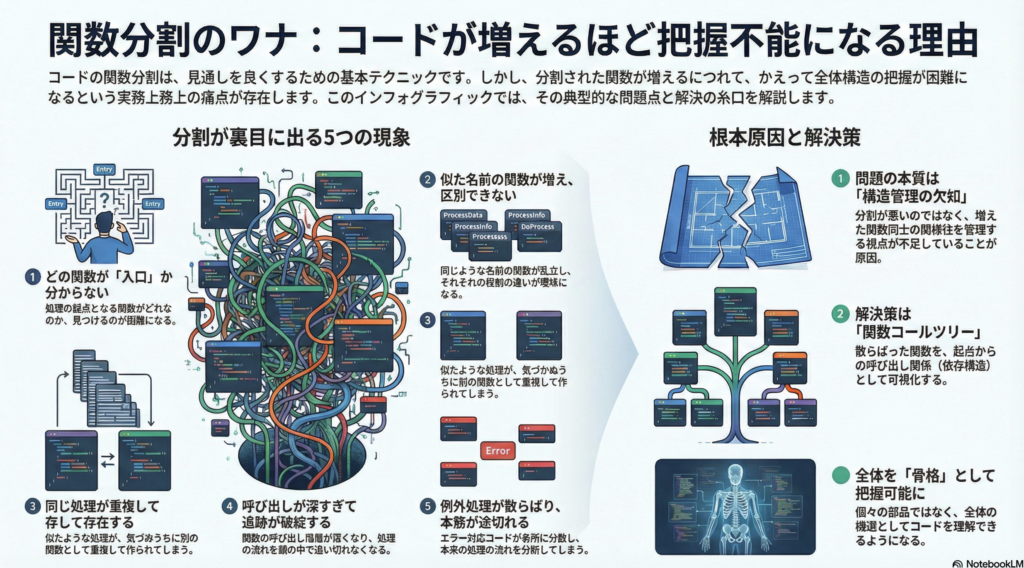
現場で一番ありがちなのは、関数分割を進めた結果、逆に全体が把握できなくなる現象です。小さいうちは分割が効きます。ところが、関数が増えてくると、次の問題が起きます。
・どの関数が入口なのか分からない
・同じような名前の関数が増えて区別できない
・似た処理が別関数で重複している
・呼び出しの深さが増え、追跡が破綻する
・例外処理が各所に散り、流れが切れる
結果として、分割したのに読めない、という状態になります。ここで重要なのは、分割が悪いのではなく、分割を管理する視点が不足している点です。関数は増えれば増えるほど、構造の管理が必要になります。構造を管理しない分割は、単に部品を散らかしているだけになります。
関数コールツリーは、この痛点に直接効きます。増えた関数を一覧にするのではなく、起点からの依存構造として配置し直すことで、全体を把握できる形に戻すからです。分割が進んだ後ほど、コールツリーの価値は上がります。
さらに厄介なのが、「共通化すれば整理できる」という発想が、かえって読みにくさを加速させる点です。似た処理を見つけると、つい手順ごと共通関数にまとめたくなりますが、現場の処理は前提条件や例外、データの意味づけが少しずつ違います。その差分を1本の共通関数に押し込むと、引数と分岐が増え、呼び出し側にはフラグ指定の“呪文”が残ります。結果として、重複は減ったのに、理解と変更が難しい中核関数が生まれます。
この状態が進むと、悲劇が起きます。共通関数が複数の業務に深く入り込み、誰も安全に直せなくなるのです。少し仕様を足すだけで、別の呼び出し元が壊れるリスクが高く、変更の影響範囲を見積もれません。すると現場は「既存の共通関数は触らない」という暗黙ルールに傾き、必要な差分は新しい関数として“横に生やす”形になります。こうして、ほとんど同じ処理をする共通関数が、名前だけ違って増殖していきます。
共通化が有効なのは、手順ではなく「安定した部品」を切り出せた場合です。たとえば純粋な変換・計算、フォーマット整形、判定ロジックなど、入力と出力が明確で文脈に依存しにくい部分は共通化しやすい一方、業務の流れや例外復帰のしかたまで一緒にすると破綻します。コールツリーで依存構造を見える化しておくと、どこが部品で、どこが手順(オーケストレーション)なのかが判別しやすくなり、共通関数化の罠に落ちにくくなります。
3.8 まとめ:コールツリーは「モスク型」になるのがよい
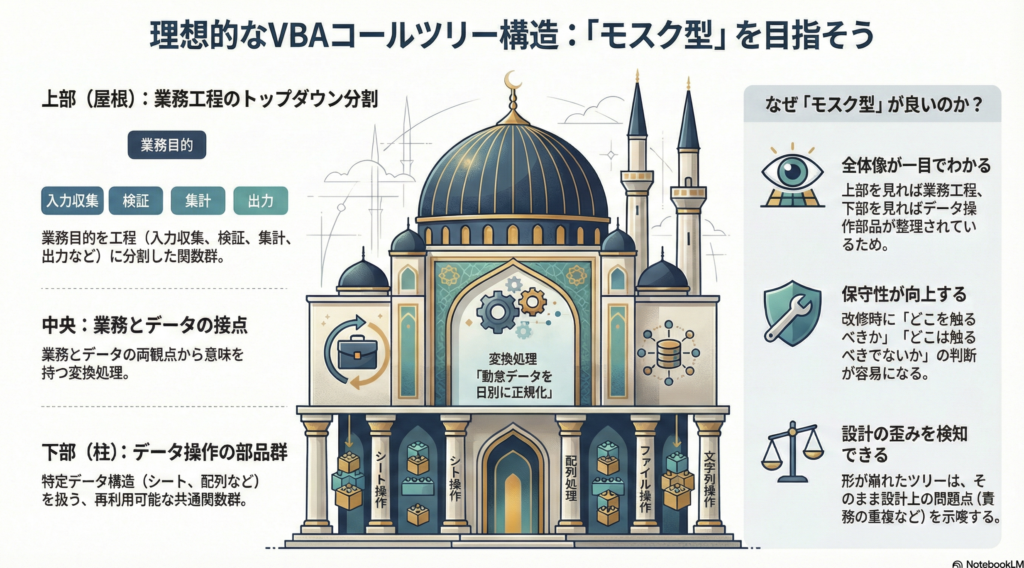
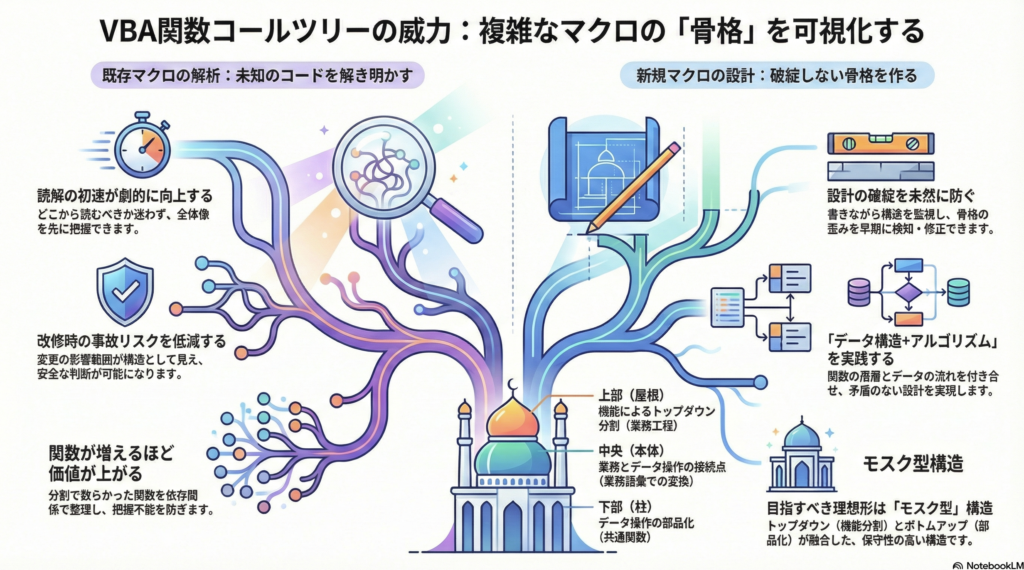
ここまで述べたように、関数コールツリーは「呼び出しの一覧」ではなく、業務マクロの骨格を可視化し、保守・解析と設計・自作の判断を支える道具です。ここで一つ、実務上の目安として押さえておくとよい形があります。それが、コールツリーが全体として「モスク型」になっている状態です。
モスク型とは、ツリーの上部に大きな屋根があり、中央にまとまりがあり、下部に細い柱が並ぶような形を指します。形の比喩に見えますが、これは単なる見た目ではなく、関数分割の原則が正しく働いた結果として現れやすい構造です。
まず、ツリーの上部は「機能によるトップダウン分割」になっているのが自然です。業務の目的を工程に割り、工程を責務に割ることで、入口から出力までの大まかな流れが関数として並びます。ここでは、入力の収集、検証、整形、集計、出力、といった業務工程の切れ目が関数境界になります。これが上部の屋根に相当します。目的は、全体の進行を人間が理解できる単位で固定することです。
次に、ツリーの下部は「データに付属するデータ操作関数群」になっているのが一般的に望ましい形です。ここで言うデータ操作関数群とは、特定のデータ構造(シート、テーブル、配列、辞書、レコード)に対して行う定型操作です。読み取り、書き込み、正規化、検索、突合、集計補助、形式変換といった部品がここに集まります。これらは業務工程そのものではなく、データを扱うための共通部品として整理されるため、下部に柱のように連なります。
そして重要なのが中央付近です。上部の「業務工程の関数」と、下部の「データ操作関数群」が、ただ上下に分離しているだけでは不十分です。実務では、業務の観点(何をしたいか)とデータ操作の観点(どう扱うか)が交差する地点が必ず現れます。ここで、業務とデータの両方の観点から意味を持つ単位として、関数が切り出されます。たとえば、単なる「配列変換」ではなく、「勤怠データを日別に正規化する」「明細を伝票単位に集約する」といった、業務語彙で説明できるデータ変換がここに置かれます。これが中央のまとまりになります。
結果として、上は機能分割の屋根、下はデータ操作の柱、中央は業務語彙で説明できる変換・集約のまとまり、という構造になり、全体がモスク型に近づきます。この形になると、次の点で保守性が上がります。
・上部を見れば、業務工程としての全体像が分かる
・下部を見れば、データ構造に対する操作部品が整理されている
・中央を見れば、業務とデータの境界がどこで確定しているかが分かる
・結果として、改修時に「どこを触るべきか」「どこは触るべきでないか」を判断しやすい
このモスク型は、トップダウンで工程を割る発想と、ボトムアップでデータ操作を部品化する発想が、互いに矛盾せずに噛み合ったときに現れやすい形です。逆に、上部が細かすぎる、下部が肥大化して業務ロジックが沈んでいる、中央のまとまりがなく責務が散っている、といった状態では、ツリーの形が崩れます。崩れた形は、そのまま設計上の歪みとして現れやすいため、コールツリーを見ながら骨格の矯正点を見つけることができます。
自作時のコールツリーの使い方(設計・実装)
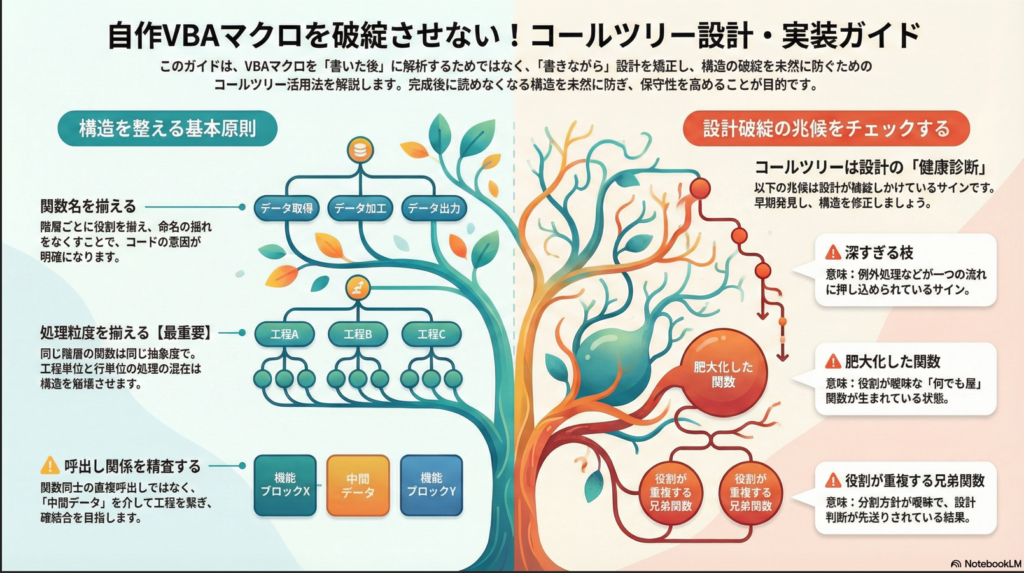
この章では、関数コールツリーを「書いた後に確認する図」ではなく、「書きながら設計を矯正するための道具」として使う方法を整理します。対象は、新規作成や大規模改修など、自分が主体となってVBAマクロを組み立てる場面です。目的は、完成後に読めなくなる構造を未然に防ぐことにあります。
4.1 関数名を揃える(命名の一貫性と読みやすさ)
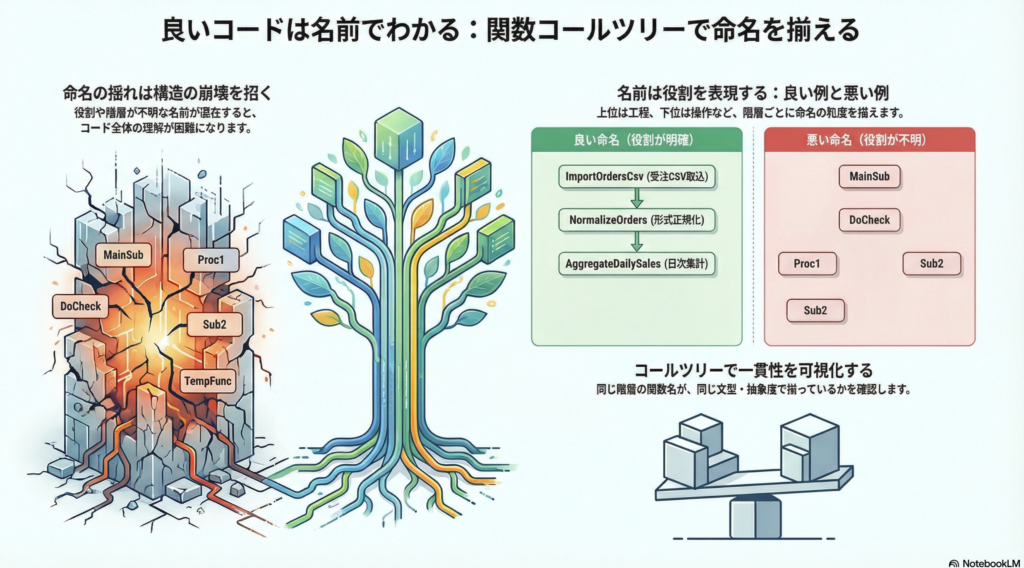
自作時にコールツリーを使う最大の利点は、命名の破綻を早期に検知できる点です。コードを1本ずつ見ていると気づきにくいのですが、コールツリーとして並べると、関数名の揺れは一目で分かります。
ここで重要なのは、関数名を「好み」ではなく「役割の表現」として揃えることです。上位関数は業務上の意味や処理段階を表し、下位関数は具体的な操作や変換を表す、という粒度の差が名前に反映されている必要があります。
例えば、上位工程に ImportOrdersCsv(受注CSV取込)/NormalizeOrders(形式正規化)/MatchMasters(商品・得意先マスタ突合)/AggregateDailySales(日次集計)/ExportReport(帳票出力)のように「工程+対象」が揃って並んでいるのに、途中へ MainSub(入口っぽいが何をするか不明)/DoCheck(何をどうチェックするか不明)/Proc1(番号で役割が消える)/Test(本番処理か検証か判別不能)/Sub2(階層も責務も読めない)といった名前が混入すると、役割の階層が崩れます。
これは単なる命名の好みではなく、その関数が工程(縦=データ変形の段)なのか、工程内の部品(横=詳細分割)なのかが名前から判別できなくなるためであり、コールツリーで縦に並べたときに同じ階層の関数名が同じ文型・同じ抽象度で読めるかどうかが重要な判断基準になります。
命名の一貫性を担保するには、コールツリーを見ながら、「この階層の関数は何を表す層なのか」を意識して命名を揃えるようにします。これにより、読みやすさと保守性が大きく改善します。
4.2 処理粒度を揃える(最重要:ツリーが崩れる典型)
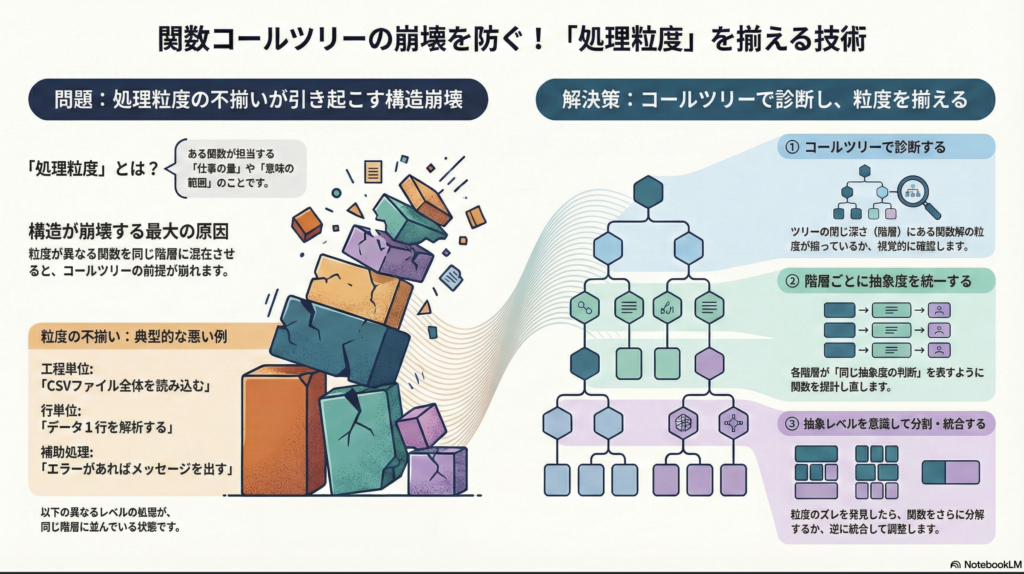
コールツリーが最も分かりやすく崩れる原因は、処理粒度の不揃いです。これは自作時の最大の地雷です。
処理粒度とは、その関数が「どれくらいの仕事量・意味範囲」を担当しているか、という尺度です。自作時には、つい次のような混在が起きます。
・ある関数は「CSVを読み込む」という工程単位
・別の関数は「1行をパースする」という行単位
・さらに別の関数は「エラーならメッセージを出す」という補助処理
これらが同じ階層に並ぶと、コールツリーは意味を失います。なぜなら、上位から下位(コールツリー上は左から右)へ降りるにつれて、処理が具体化するという前提が崩れるからです。
コールツリーを使うと、階層ごとの粒度のズレが視覚的に露呈します。同じ深さにある関数が、ユーザインタフェースレベルなのか、業務機能分割なのか、業務共通関数なのか、部品レベルなのか、共通の変換処理なのかなどを確認し、ズレているものは分解するか、統合する必要があります。
処理粒度を揃えることは、見た目を整える作業ではありません。ツリーの各階層が「同じ抽象度の判断」を表すように設計することです。ここが揃っていないと、後からどれだけ命名を直しても、構造は読めるようになりません。
4.3 呼出し関係を精査する(パイプライン化と中間データの境界)
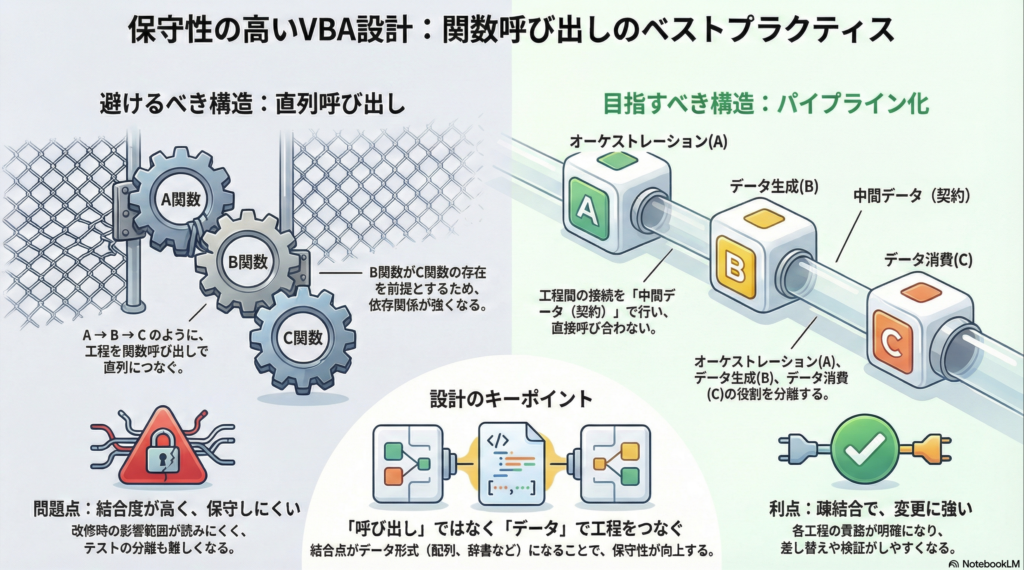
自作時に必ず立ち止まって確認すべきなのが、呼び出し関係の形です。ここでの論点は、ツリーの深さそのものではなく、工程間の結合が「関数呼び出し」で固定されていないか、そして可能であれば「中間データ」を介したパイプラインとして組み立てられているかです。コールツリーは、この結合の置き場所を可視化し、設計を矯正するために使います。
基本方針として、可能であれば次の形に寄せます。
A 関数が工程の順序を管理する(オーケストレーション)
B 関数は中間データを生成して返す(生成)
C 関数は中間データを受け取って処理する(消費)
呼び出しとしては A→B、A→C となり、B と C は直接呼び合わない構造です。ここで重要なのは、B と C の接続が「関数呼び出し」ではなく「中間データ(契約)」になっている点です。工程間の合意がデータ形式として固定されるため、各工程の責務が明確になり、差し替えや検証がしやすくなります。
対照的に、工程を A→B→C の直列としてつなぐ形では、B が C の存在を前提に動く構造になりやすく、依存が強くなります。依存が強いと、改修時の影響範囲が読みにくくなり、テストの分離も難しくなります。コールツリー上では「B の下に C がぶら下がっている」形として現れますが、これは単なる見た目の問題ではなく、工程間の境界が曖昧になっているサインです。
ただし、実務では N:1 のデータに対して個別要素を処理するため、自然にループ構成となる処理が多く存在します。したがって、B→C へ「ループしながら次工程へ渡す」こと自体を問題視するのではなく、書きやすさを優先して十分に検討しないまま B→C の直列呼び出しに固定してしまうことを問題にすべきです。本来は中間データを介して分離した方がよい場面でも、呼び出しでつないでしまうと、責務の境界が呼び出し構造に埋め込まれ、後から変更しにくくなります。直列に関数をつなぐのは直感的で簡潔に見えますが、結果として結合度の高い、保守しにくい構造を生む場合があります。
このため、ループ処理が避けられない場面でも、まず検討すべきは「結合点をデータに置けないか」です。中間データの格納先としては、ワークシート、配列、辞書、構造化されたグローバルデータ等といった選択肢があります。結合点をデータ(契約)として設けることで、工程間の依存は「関数同士」ではなく「データ形式」に集約され、疎結合に寄せやすくなります。
もちろん、すべてを中間データ化すればよい、という話ではありません。中間データの保持自体がコストになる場合があります。たとえば、全量保持が現実的でないサイズ、逐次処理が要件として正しい場合、性能やメモリの制約が強い場合などは、ストリーミングとして流す設計が妥当になります。この場合でも重要なのは、直列呼び出しを採る理由が明確であり、設計として管理できることです。結合が強くなる分、どこで検証するのか、どこで例外を握るのか、どこで再開できるのか、といった責務の分界を明文化しておく必要があります。
コールツリーでの点検項目は、次の三つに整理できます。
第一に、データ生成(B)とデータ消費(C)が分離されているか。
第二に、工程間の結合点が「呼び出し」ではなく「中間データ(契約)」になっているか。
第三に、直列呼び出しを採っている場合、その理由と責務の境界が説明できるか。
この観点でツリーを眺めると、コールツリーは単なる階層図ではなく、設計の骨格を点検する道具になります。自作時は、処理を書き足してから整えるのではなく、呼び出し関係が固まる段階で「結合をデータに置けているか」を確認し、必要なら早めに構造を寄せることが、破綻しにくい設計に直結します。
4.4 破綻の兆候チェック(深すぎる枝、肥大化、兄弟の役割重複)
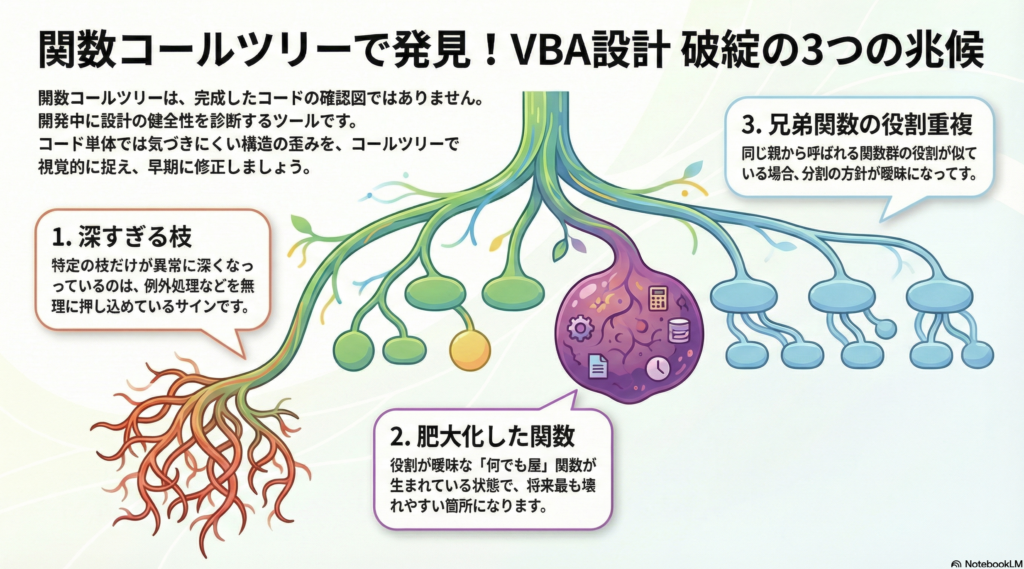
自作時のコールツリーは、完成図ではなく、健康診断の結果として見るべきです。次のような兆候が出ていたら、設計が破綻しかけています。
一つ目は、特定の枝だけが異常に深くなっている場合です。これは、例外処理や特殊ケースを一つの流れに押し込めているサインです。深さが増えた理由を説明できない場合、その枝は分割や再配置が必要です。
二つ目は、特定の関数が肥大化している場合です。ツリー上では一つのノードでも、中身が巨大になっていることがあります。これは「何でも屋」関数が生まれている状態で、将来的に最も壊れやすい箇所になります。コールツリーで見て、上位なのか下位なのか判断がつかない関数は、役割の再定義が必要です。
三つ目は、兄弟関係にある関数の役割が重複している場合です。同じ親から呼ばれている関数が、似た名前、似た処理、似た引数を持っている場合、分割の方針が曖昧になっています。これは、設計判断を先送りにした結果としてよく現れます。
これらの兆候は、コード単体では気づきにくいものです。コールツリーという形にすることで、初めて全体の歪みとして観測できます。自作時にコールツリーを見る習慣を持つことは、後から読む人のためだけでなく、書いている自分を助ける行為でもあります。
解析時のコールツリーの使い方(他人マクロ読解)
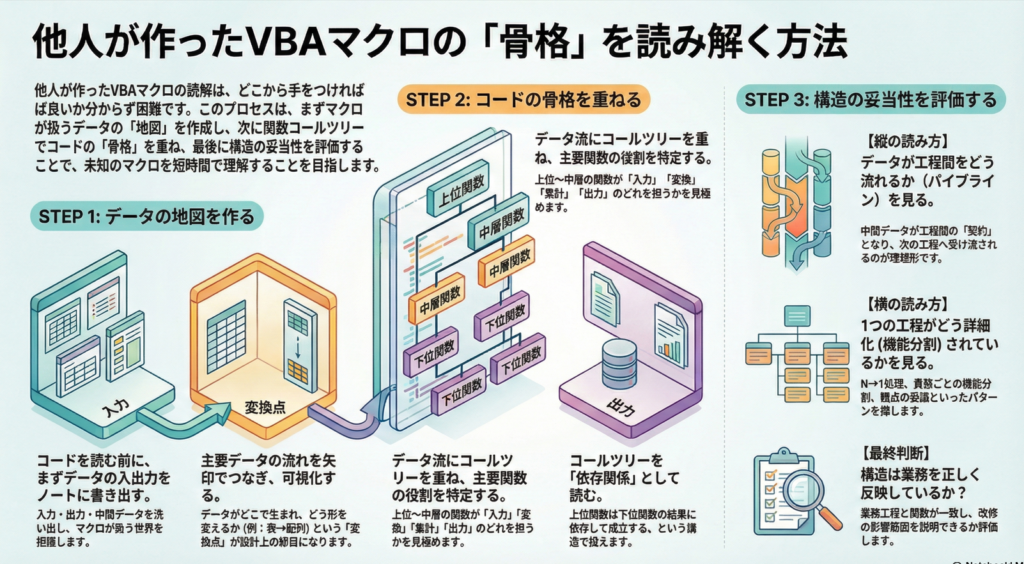
この章では、他人が作った既存マクロを短時間で理解し、改修判断につなげるための読み方を整理します。ここでの目的は「全部読む」ことではありません。未知マクロの骨格を確定し、主要データの流れと上位関数の役割を先に固めることです。細部の正しさは後で検証できますが、骨格の取り違えは最後まで尾を引きます。
5.1 まずノートに洗い出す(手順1全体概要図)
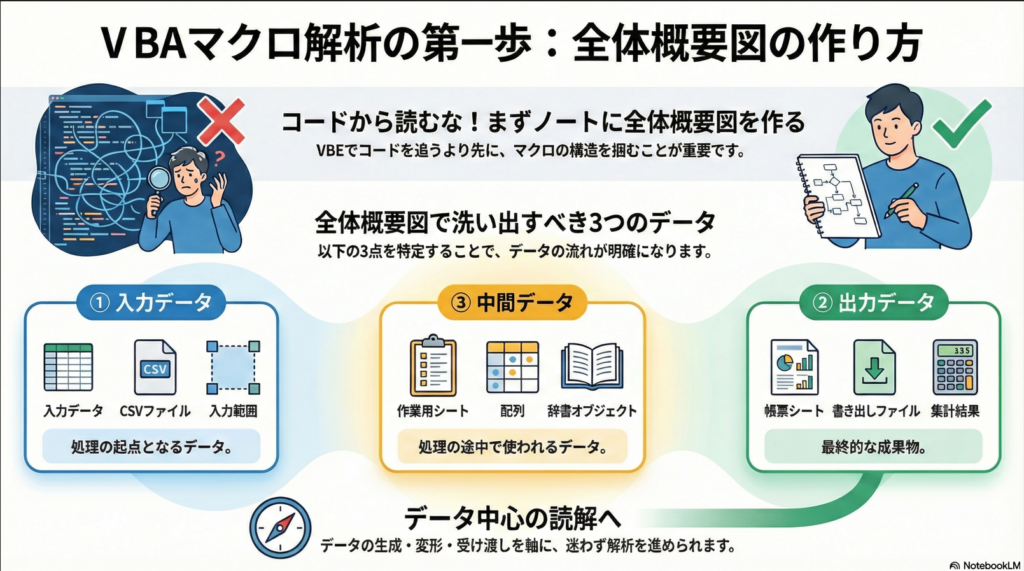
最初にやるべきことは、VBE上でコードを追い始めることではなく、ノートに全体概要図を作ることです。理由は単純で、未知マクロの理解は「行を読む」より先に「構造を掴む」必要があるからです。
ここでの全体概要図は、DFD(Data Flow Diagram)の考え方を取り入れています。DFDは本来、業務やシステムを設計するための手法ですが、本記事での目的は「新規設計」ではありません。すでに存在するマクロを俯瞰し、データがどのように変形しながら流れるかを把握するための基盤を、後付けで作ることにあります。つまり、設計図を描くのではなく、既存物の構造を読み解くための地図を起こす、という位置づけです。
全体概要図では、次の三点だけを最初に押さえます。ここで言う「押さえる」は、処理手順を追うことではなく、マクロが扱うオブジェクトを、構造を反映する形で書き下すことです。
・入力データは何か(どのシート、どのファイル、どのCSV、どの範囲)
・出力データは何か(どのシート、どの帳票、どのファイル、どの範囲)
・中間データは何か(中間シート、配列、辞書、テーブル、ワーク領域)
この三点を先に確定すると、以降の読解は「起点から順に追う」ではなく、「どのデータがどこで生成され、どこで変形され、どこへ渡るか」を軸に進められます。起点(ボタンやイベント、実行Sub)の特定は重要ですが、最初の一手としては後回しにして構いません。まずデータの入出力と中間表現を押さえ、次にそれらに関与する上位関数をコールツリーで重ねる、という順序にすることで、未知マクロでも初動が安定します。
5.2 主要データの流れを書く(手順2シート・配列・辞書・入出力)
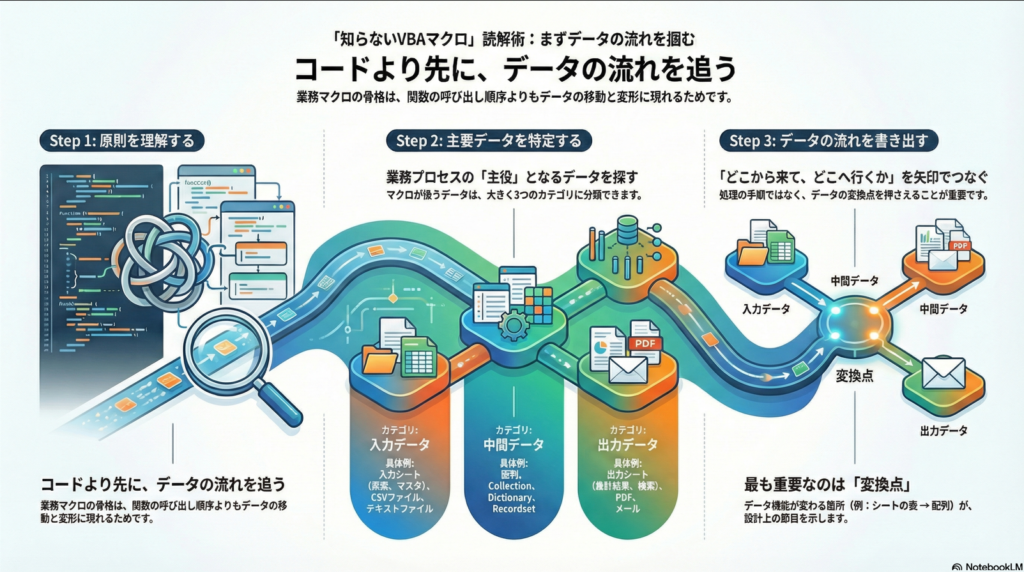
次に、主要データの流れを書き出します。コールツリーを見る前にデータを押さえる理由は、業務マクロの骨格は「関数の構造」よりも「データの移動と変形」に現れるからです。
ここで扱うデータは、業務上の主役です。典型的には次のようなものです。
・入力シート(原票、マスタ、勤怠、売上など)
・外部入出力(CSV、テキスト、PDF、印刷、メール)
・中間表現(配列、Collection、Dictionary、Scripting.Dictionary、Recordsetなど)
・出力シート(集計結果、帳票、エラー一覧、差分一覧など)
書き方は単純で、「どこから来て、どこで形が変わり、どこへ行くか」を矢印でつなぎます。ここで重要なのは、処理の手順を細かく書くことではなく、変換点を押さえることです。データが構造を変える箇所(表→配列、配列→辞書、辞書→表など)が、設計上の節目になります。
5.3 コールツリーで主要関数の関与を重ねる(手順3トップ〜中層)
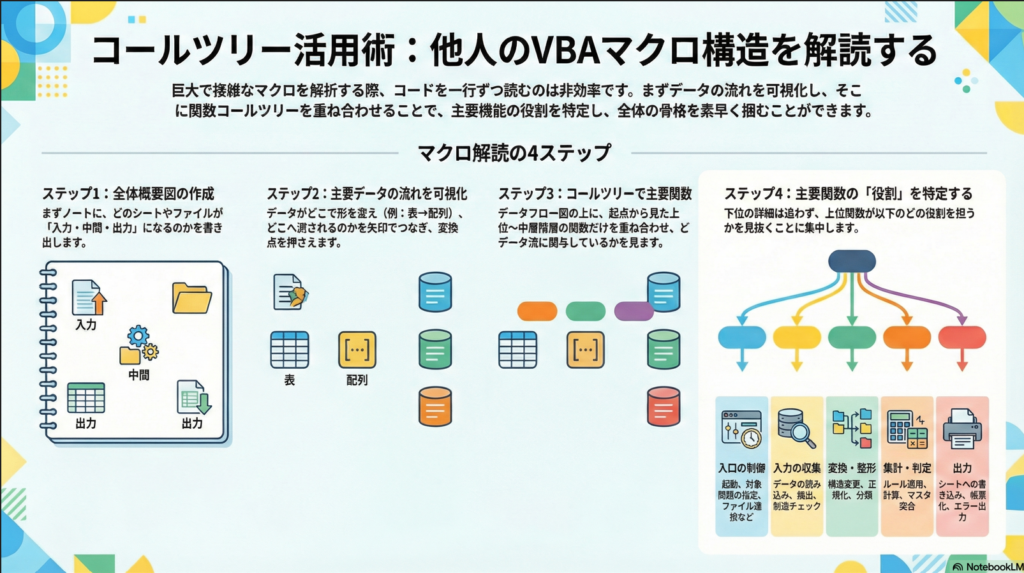
全体概要図とデータ流が描けたら、ここで初めてコールツリーを使います。目的は、全関数を網羅することではなく、トップ〜中層の主要関数が、どのデータ流に関与しているかを重ねることです。
まず、起点から見たコールツリーの上位数階層(トップ〜中層)だけを見ます。ここで探すのは、次の役割を担う関数です。
・入口の制御(起動、対象期間、対象者、ファイル選択など)
・入力の収集(読み込み、抽出、前提チェック)
・変換・整形(構造変更、正規化、分類)
・集計・判定(ルール適用、計算、突合)
・出力(書き込み、帳票化、エラー出し、保存)
この段階では、下位のユーティリティ関数を追いません。上位の役割を確定させるのが先です。上位関数の役割が決まれば、下位は「その役割を実現する部品」として読み下せます。逆は成立しません。
5.4 コールツリーをどう読むか(LET的な依存の捉え方)
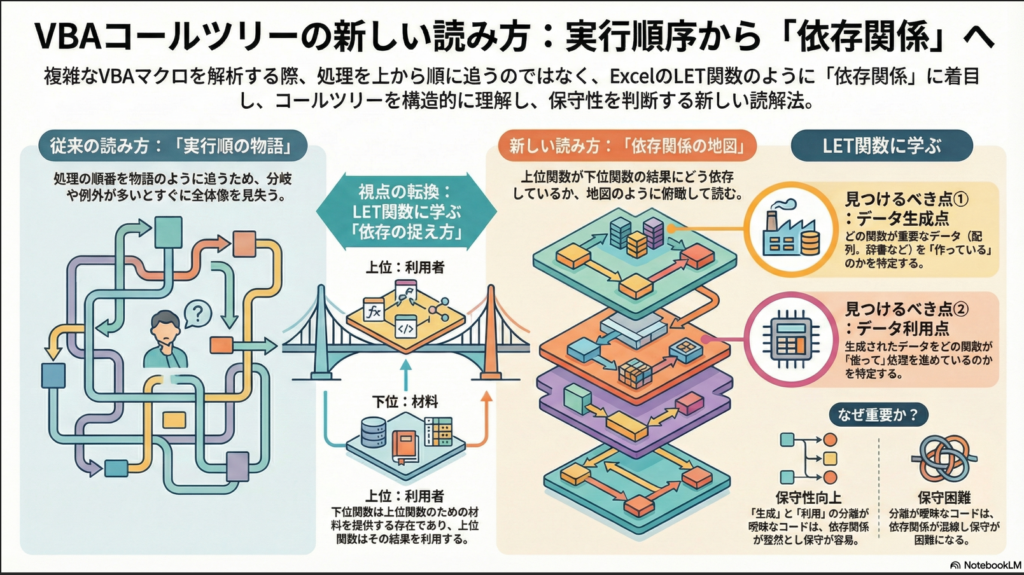
コールツリーの読み方で重要なのは、実行順の物語として読むのではなく、依存関係として読むことです。ここでの依存関係の捉え方は、ExcelやPower QueryのLET関数に近い発想が有効です。
LET関数では、値は「前段の定義に依存して決まる」形で積み上がります。同様に、コールツリーでは、上位関数は下位関数の結果に依存して成立します。つまり、下位は上位の材料であり、上位は下位の利用者です。
この見方をすると、重要な点が二つ見えます。
・どの関数が「データを作っている」のか(生成点)
・どの関数が「データを消費している」のか(利用点)
この区別が曖昧なコードは、保守が難しくなります。依存が混線しているからです。解析時は、生成と消費がどこで切れているかを、ツリーから先に見つけます。
5.5 上→下:共有データで流れる(パイプラインとして読む)
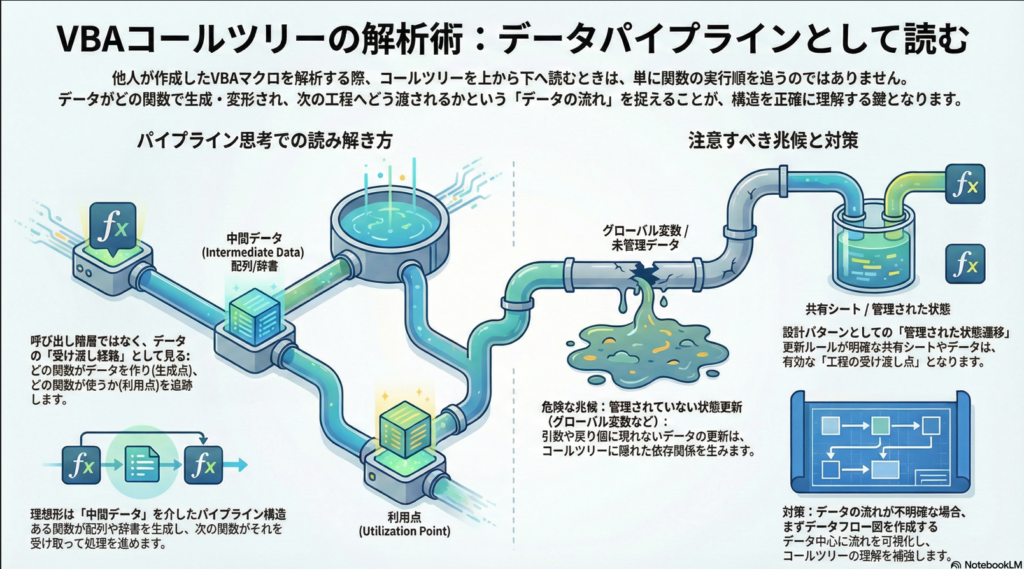
コールツリーを上から下へ読むときは、関数の羅列として読むのではなく、共有データがどのように流れているかを追います。ここで重視するのは「上位/下位」という序列ではなく、データの受け渡しです。具体的には、ある関数が中間データ(配列、辞書、ワークシート参照、設定値など)を用意し、その中間データが別の関数へ渡されて処理が進む、という関係として読みます。言い換えると、コールツリーを「呼び出しの階層図」としてではなく、「データの受け渡し経路が重なった骨格図」として読む、ということです。
望ましい形は、同じ中間データを受け渡しながら処理が段階的に進むパイプラインです。ある関数が中間データを生成し、次の関数がそれを受け取って変形し、さらに次の関数が受け取って集計・判定する。こうした流れが見えると、ツリーは「骨格」として読みやすくなります。この段階で確定したいのは、どの関数が偉いかではありません。どの関数がどのデータを生成し、どの関数がそれを消費し、どの地点でデータの形が変わるのか、という依存関係の実体です。ここが確定すると、処理の詳細を読む順番も自然に決まります。
一方で、ツリーを追うほどグローバル変数やシートへの書き込みが増える場合は注意が必要です。問題になるのは「書き込みがあること」そのものではなく、書き込みが無秩序で、データの経路と更新条件が追えない状態です。引数や戻り値に現れない更新が増えると、依存関係がコールツリーに表れにくくなり、「どの関数が、いつ、どのデータを変えたのか」が追跡しづらくなります。結果として、流れの復元が難しくなり、改修時の影響範囲も読み違えやすくなります。
ただし、シートへの構造化された書き込みや、構造化されたグローバルデータの変更は、状態遷移プログラミングとして位置づけられます。たとえば、特定の中間シートを「工程の受け渡し点」として使う、共有データを「状態コンテナ」として定義し、更新箇所と更新規約を固定する、といった設計は十分に成立します。状態(シートや共有データ)をどの段階で、どのルールで更新するかが管理されているなら、それは設計上の選択であり、直ちに問題とは言えません。むしろ、更新箇所が限定され、状態の遷移が明示できるなら、可観測性と保守性は上がります。解析の観点では、状態更新の有無よりも「状態更新が設計として管理されているか」が本質になります。
したがって解析時は、「状態更新があるか」ではなく、「状態更新が管理されているか」を観察します。管理が弱い場合、コールツリーだけではデータの流れを復元しにくいため、データ流の図(入力・出力・中間データをDFD的に整理したもの)を優先して補強します。具体的には、どのデータがどこで生成され、どこで更新され、どの条件で遷移し、最終的にどこへ出力されるのかを別途確定させます。これにより、呼び出し構造に現れない依存(状態遷移として埋め込まれた依存)を、データ中心に回収したうえで読解を進められます。
5.6 左→右:細分化の進み方でみる(N→1、機能分割、変換)
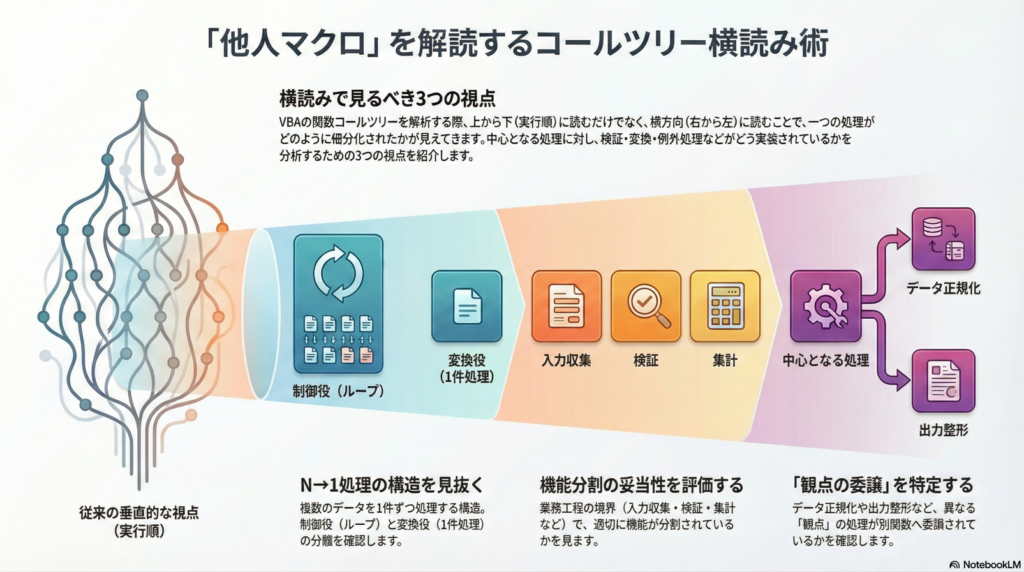
コールツリーは縦(上→下)に読むだけでは不十分です。上→下は、同じデータがどの関数へ渡され、どの段階で変形されるかという「パイプライン(段階)の進行」を読む視点でした。
これに対して、次は横(右→左)に読みます。ここで見たいのは、階層の違いではなく、1つの関数(ある処理単位)を中心にして、その周辺にどのような処理が寄せられているか、つまり「細分化がどの方向に進んだか」です。具体的には、中心となる処理に対して、検証、正規化、変換、集計、例外処理、出力整形といった要素が、どの順で、どの単位で切り出され、どこまでが同じ責務として保持されているかを確認します。
右→左で読む理由は、実務のコードでは「中心の処理(やりたいこと)」が先にあり、その周囲に対応処理が付け足されて肥大化することが多いからです。これを確認することにより、処理が付け足された順序や、依存が増えた経路が見えやすくなります。これにより、どこで境界を切るべきか、どこを中間データに落とすべきか、どこを状態遷移として管理すべきか、といった分割の妥当性を判断できます。
この横読みでの観察点は三つです。
一つ目は、N→1 の処理形です。ここで言う N→1 は「複数のデータ(N件)を、1件ずつ同じ変換関数へ渡して処理する」ことを指します。入力データがN件あり、その1件ごとの処理が同じ変換ロジックに集約されるため、コード上はループ構成として現れます。コールツリーを右→左に読むときは、この「1件処理の核」がどこに置かれ、その核を誰が制御しているかを見ることになります。
実務では、この N→1 は「制御の中心となる呼び出し側の関数」と「実際のデータ変換を行う関数」の組み合わせとして現れることが多くなります。呼び出し側は、対象範囲の決定、順序、停止条件、例外時の扱い、ログや集計のタイミングといった制御責務を持ち、変換側は、入力1件を所定の中間表現へ正規化する、検証する、変形する、といった変換責務を持ちます。ここが分離されていると、変換ロジックは再利用しやすくなり、制御の変更(対象条件や例外方針の変更)が変換ロジックへ波及しにくくなります。ジャクソン法の文脈で言えば、構造(制御)と変換(手続き)を切り分け、データの形に沿って安定した骨格を先に作る、という発想に近い整理です。
二つ目は、機能分割です。ここで言う機能分割は、入力や出力の種類に応じて場当たりに処理を散らすことではありません。トップダウン設計の結果として、上位の構造が必然的に現れる、という意味での分割です。たとえば、「入力の収集」「検証」「正規化」「集計」「出力」のように、業務工程や責務の境界で段階を分け、その段階ごとに関数を置く。これはデマルコ的に言えば、DFDで描ける処理(プロセス)の境界を、コード側の構造へ写像する行為です。
コールツリーを右→左に読むときは、中心となる処理から逆に辿って、どの責務が「別の機能」として切り出され、どこに委譲されたかを確認します。機能分割が適切であれば、委譲の理由(工程が違う、観点が違う、責務が違う)が説明でき、境界がデータや契約(中間データ、引数、戻り値)として表現されています。逆に、委譲の理由が曖昧で、単に処理を薄く切っただけの分割になっていると、骨格は増えても理解と保守は楽になりません。
三つ目は、変換(観点の委譲)です。ここでの「変換」は、粒度が単純に細かくなることを指しません。中心となる処理が抱えている複数の観点を、それぞれ別の関数へ委譲することとして捉えます。典型的には、データの正規化、型や単位の揃え、分類、突合、集計、出力整形といった「同じ入力に対して別の観点で意味付けをする処理」が分離されます。
このとき重要なのは、委譲が「呼び出しの都合」ではなく「観点の境界」に基づいているかです。観点の境界で切れていれば、変換は共通化されやすく、別用途への転用やテストも容易になります。また、データ変換の結果が中間データとして固定されていれば、工程間の結合点がデータ(契約)になり、プログラミングの壺で繰り返し語られる「構造を安定させる」方向にも合致します。逆に、観点が混在したまま処理が増えていくと、例外対応や分岐が中心処理へ吸い寄せられ、右側へ付け足した処理が左側(中心)へ逆流しやすくなります。解析時は、どの観点がどこへ委譲され、何が中間データとして固定されているかを手がかりに、分割の妥当性と保守性を判断します。
5.7 下につなげるか、右に掘るか(分割の妥当性と保守性)
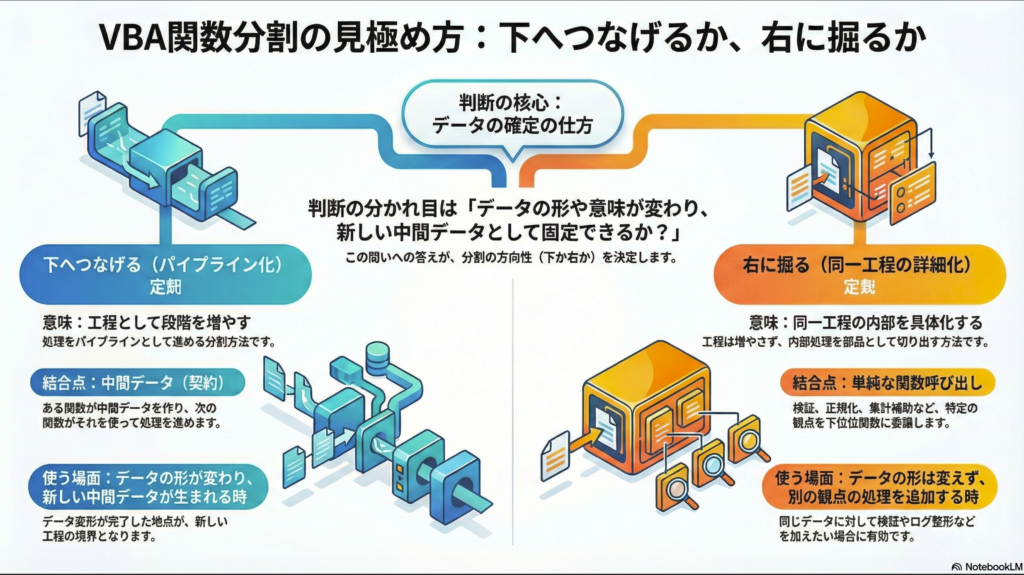
解析時には、「この処理は下へつなげるべきか、右へ掘るべきか」を判断する場面が必ず出ます。ここで言う下と右は、ツリー上の見た目ではなく、分割の意図(設計上の意味)を指します。
下へつなげるとは、工程として段階を増やし、中間データを結合点(契約)としてパイプラインを進めることです。実装上は、ある工程の関数が中間データを確定させ、その中間データを入力として次工程の関数を呼ぶ、という形になります。ただし重要なのは、パイプライン化は「細かい下請けを増やす」ことではなく、「中間データを介して工程境界を作る」ことだという点です。コールツリー上では、同じレイヤに並ぶ複数の工程関数(業務関数)が、それぞれ次の工程へ中間データを渡していく構造として現れやすくなります。つまり、パイプラインの進行は、データの確定と受け渡しの繰り返しとして縦方向に観察されます。
右へ掘るとは、工程を増やすのではなく、同一工程の内部を詳細化することです。実装上は、ある関数の内部処理を分割し、下位の呼び出しとして切り出していく形になります。ここで作られる関数は、中間データによる工程境界を作るというより、同じ工程の中で「観点の委譲(検証、正規化、変換、集計補助、出力整形など)」を行うための部品として現れます。したがって横方向の分割は、基本的に「ある関数が、詳細化された関数を呼び出す」という単純な呼び出し構造として実装されます。
この判断は、単に迷ったときの救済ではありません。業務関数をどう分割するか、その設計軸そのものです。業務を分割した結果、同一工程の内部が右方向に詳細化される場合もあれば、工程境界を立てて下方向にパイプライン化される場合もあります。コールツリー上ではどちらも「分割」に見えますが、意味が違います。
判断基準の中心は、データの確定の仕方です。データの形や意味が変わり、新しい中間データとして固定できるなら、それは工程境界を置けるサインであり、下へつなげる(パイプライン化する)方向が自然になります。中間データは工程間の結合点(契約)であり、新しい中間データが生まれるということは、DFDの観点では新しいデータ(ストア/流れ)と新しいプロセスの組が立ったことを意味します。DFDでは、データ(入力・中間・出力)とプロセス(変換・集計・検証)が交互に現れ、データが確定するたびに工程が一段進みます。したがって、コールツリーを縦に読む視点は、実質的にDFDの縦方向(データ変形の進行)と対応し、中間データが増えるほどパイプラインが下へ伸びるのは自然です。
一方、データの形は変えずに、同じデータに対して別の観点の処理を追加したい場合は、右へ掘る(詳細化する)方向が自然です。ここでの「別の観点」とは、同一工程の内部で必要になる検証、正規化、分類、突合、ログ整形、例外の整理などです。これらは工程を増やすより、同じ工程内で責務を委譲して見通しを良くする方が効果的なことが多い。右方向の分割は、そのための手段です。
注意すべきなのは、右へ掘ることを例外処理や特殊ケースの逃げ先にしてしまうことです。例外や特殊ケースを無制限に右側へ増やすと、詳細化ではなく場当たりの分岐が増え、工程の見通しが崩れます。逆に、変換点でもないのに下へ下へと積み上げると、中間データの契約が曖昧なまま工程だけが細切れになり、深すぎて追跡が難しくなります。
したがって解析時は、コールツリーとデータ流(入力・出力・中間データをDFD的に整理した図)を突き合わせて分割の根拠を確認します。縦に伸びているなら「どの中間データが確定し、何が次段へ渡るのか」を言語化できるか。右に掘れているなら「同一工程内で、どの観点がどの関数へ委譲されているか」を言語化できるか。これが言語化できる構造であれば、分割は保守性に寄与し、改修判断も安定します。
5.8 業務構造を正しく表しているか(設計判断の基準)
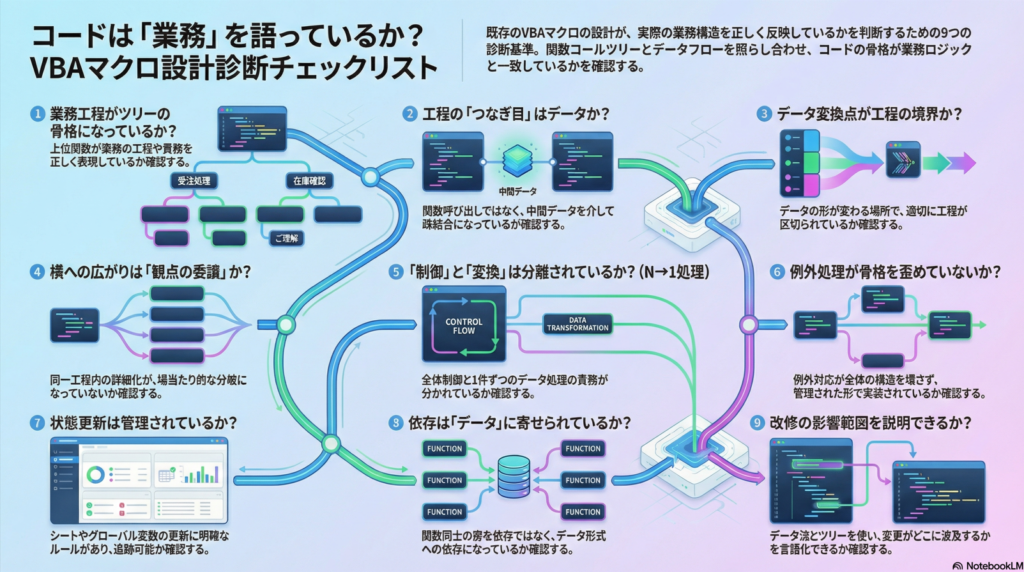
最後に、解析の目的は「理解した気になること」ではなく、設計として妥当かどうかを判断することです。そのために、コールツリーとデータ流(入力・出力・中間データをDFD的に整理した図)を重ね、呼び出し構造とデータ変形が同じ骨格を指しているかを確認します。判断は「関数の階層がきれいか」ではなく、「業務とデータが矛盾なく説明できるか」で行います。
設計判断の観点は次のとおりです。
・業務工程が、ツリー上で工程関数として並び、工程の順序と責務が説明できるか
・各工程の結合点が、中間データ(契約)として明示できるか。中間データを作ったところでパイプラインが下に進んでいるか
・データの変換点が妥当な境界になっているか。変換点が曖昧なのに工程だけが増えていないか(縦の根拠があるか)
・同一工程の詳細化(右方向の分割)が、観点の委譲として整理されているか。場当たりな分岐や例外の付け足しで右に広がっていないか
・N→1(N件のデータを1件ずつ処理関数へ渡す形)の中心がどこにあり、制御側と変換側の責務が分離できているか。影響が1点に集中しすぎていないか
・例外処理が骨格を歪めていないか。例外が工程境界を壊していないか、または右方向の詳細化として管理されているか
・状態遷移(構造化されたシート書き込み、構造化されたグローバルデータ更新)が、更新箇所と更新規約として管理されているか。隠れた依存として拡散していないか
・依存が「呼び出し」ではなく「データ(契約)」に寄っているか。工程間がデータで疎結合になっているか
・改修の影響範囲を、データ流とツリーの両方から説明できるか。どの中間データが変わり、どの工程・観点に波及するかを言語化できるか
これらが満たされていれば、コードが古くても保守可能性は高いと言えます。逆に、業務工程がツリー上で説明できない、工程境界となる中間データが確定していない、データ流が状態更新の陰に隠れている、右方向の詳細化が例外の寄せ集めになっている、といった状態では、改修前に骨格(工程と中間データの境界、観点委譲の整理、状態遷移の管理)を立て直す必要があります。
滝Libでの導入:インストールと登録手順
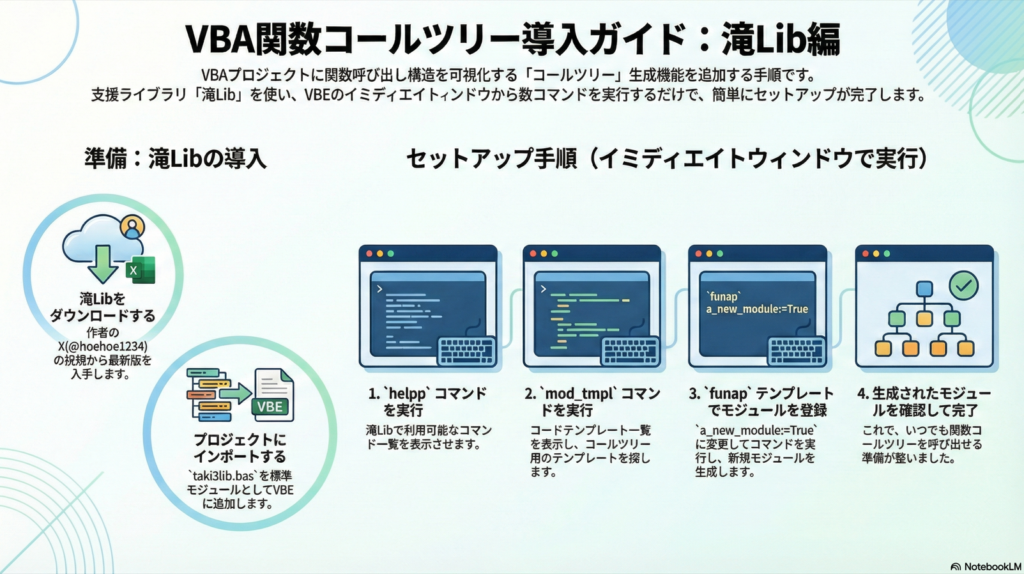
この章では、滝Libを用いて「関数コールツリー表示関数」をプロジェクトにセットアップする手順を説明します。
操作はすべて VBE のイミディエイトウィンドウから行い、実行ログがそのまま再現可能な手順になります。
目的はシンプルで、滝Libをインストールし、コールツリー生成用の関数を自分のプロジェクトに追加できる状態を作ることです。
複雑な設定や依存関係はなく、既存のブックにそのまま追加して使える設計です。
6.1 滝Lib(taki3lib)の導入
滝Libは、Excel VBA プロジェクトに追加して使う支援ライブラリです。MIT License で配布されており、個人・業務用途を問わず利用できます。
導入に必要なファイルは次の2点だけです。
・taki3lib.bas。滝Lib 本体です。VBE から標準モジュールとしてインポートします。
・taki3lib.json。補助的な設定ファイルです。マクロと同じフォルダに配置します。配置されていなくても致命的な問題はありませんが、滝Libのkoip(汎用データ表示コマンド)の設定などが記載されていますので、配置を推奨します。これ以外のファイル(リーフレット等)は、導入自体には不要です。
滝Libは参照設定や外部ライブラリに依存せず、既存のブックにそのまま追加して使用できるクリーンな設計ですので安心してご利用ください。
X(旧ツイッター、@hoehoe1234)で以下のような投稿を見つけて最新版をダウンロードしてご使用ください。
#ほえ滝Lib
Taki3lib VerX.Y.Z released.
MIT License.
Add taki3lib.bas to your project.
Place taki3lib.json in the macro folder.
Type `helpp` to start.
Type `whats_new` to see new features.
Download URL below:
https://www.dropbox.com/scl/fo/c4oxwqm7gryf3ubl73inz/AAtqQhPTRyn0eltYrw4CWLI?rlkey=04t9vdj57ia1s7rlqxa2wahla&st=yj8qdjd4&dl=0
6.2 導入の流れ(全体像)
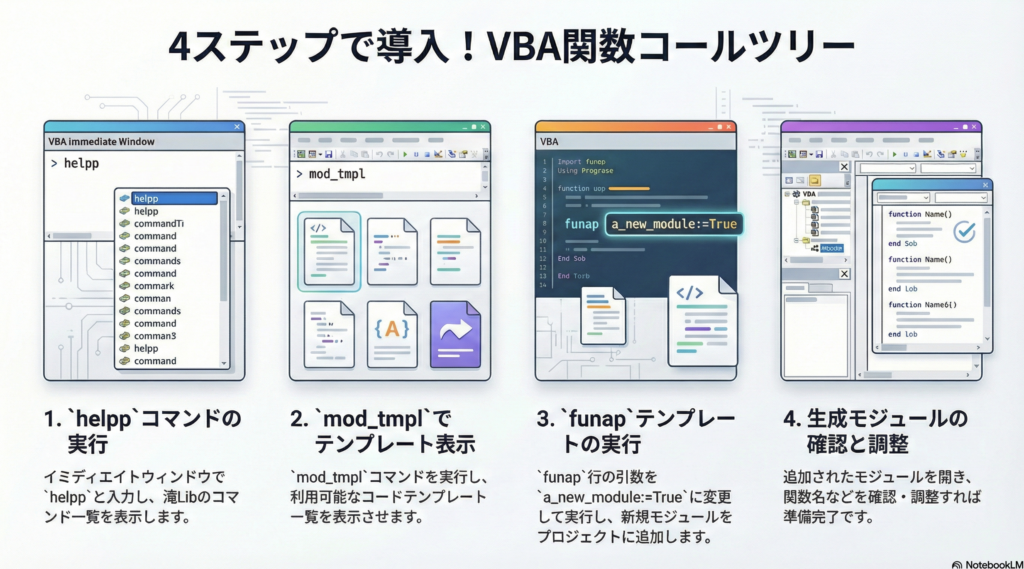
滝Libをインストールした後に、関数コールツリー導入までの流れは、次の4ステップだけです。
・イミディエイトウィンドウで helppコマンド を実行する
・mod_tmplコマンド を実行してテンプレ一覧を表示する
・funapコマンドテンプレートを True で実行する
・生成されたモジュールを確認・調整する
以降、この流れに沿って具体的な操作を説明します。
6.3 helpp コマンドを実行する
まず、VBE を開き、イミディエイトウィンドウを表示します。
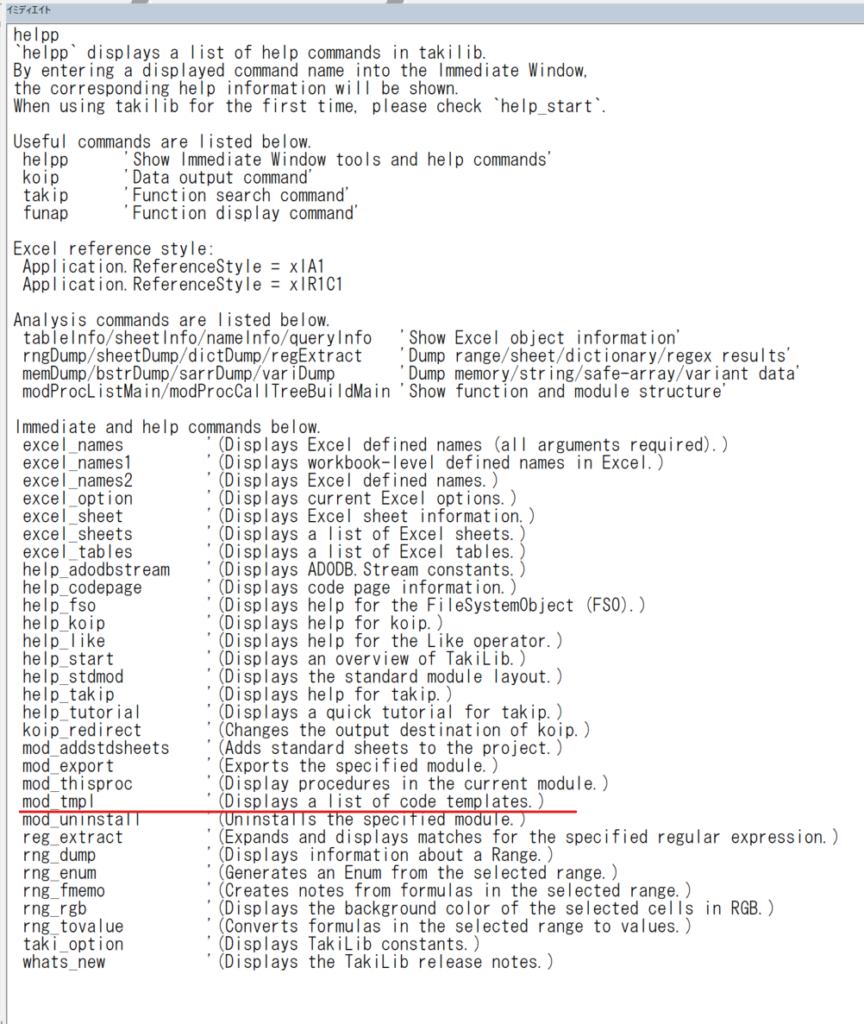
イミディエイトウィンドウで、次のコマンドを実行します。
helpp
helpp は滝Libの入口です。
実行すると、使用可能なコマンド一覧が表示されます。
6.4 mod_tmpl によるテンプレ表示
一覧の中から、次の行を探します。
mod_tmpl
これは「コードテンプレート一覧を表示する」ためのコマンドです。
この行にカーソルを合わせて実行します。
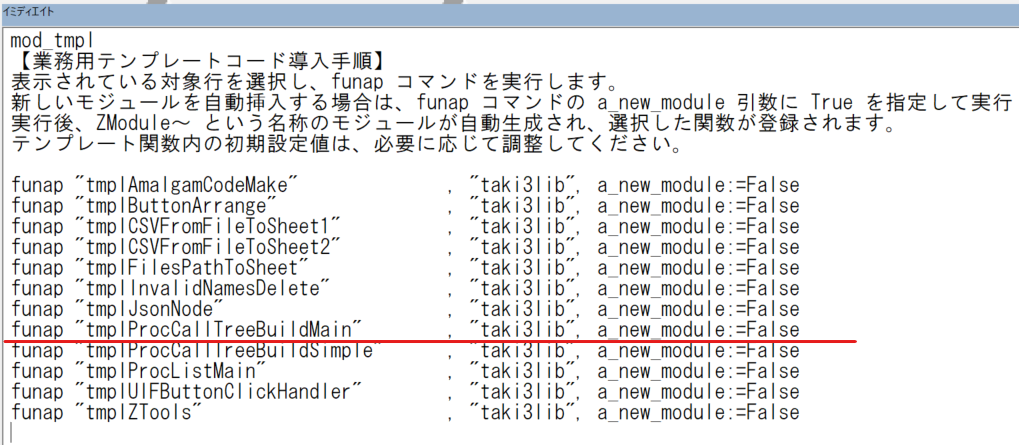
すると、滝Lib が用意している各種テンプレートが表示されます。
6.5 funap テンプレを使ったモジュール登録
テンプレ一覧の中に、次のような funap の呼び出し行が表示されます。
funap "tmplProcCallTreeBuildMain", "taki3lib", a_new_module:=False
この行が、関数コールツリー生成用テンプレです。まずは表示内容を確認し、問題なければ a_new_module の値を次のように変更します。
funap "tmplProcCallTreeBuildMain", "taki3lib", a_new_module:=True
この状態で実行します。実行すると、プロジェクトに「ZModule1」(数値は連番)の新規モジュールが追加されます。
このモジュールには、コールツリー生成のためのテンプレート関数が追加されています。
6.5 生成されたモジュールの確認と調整
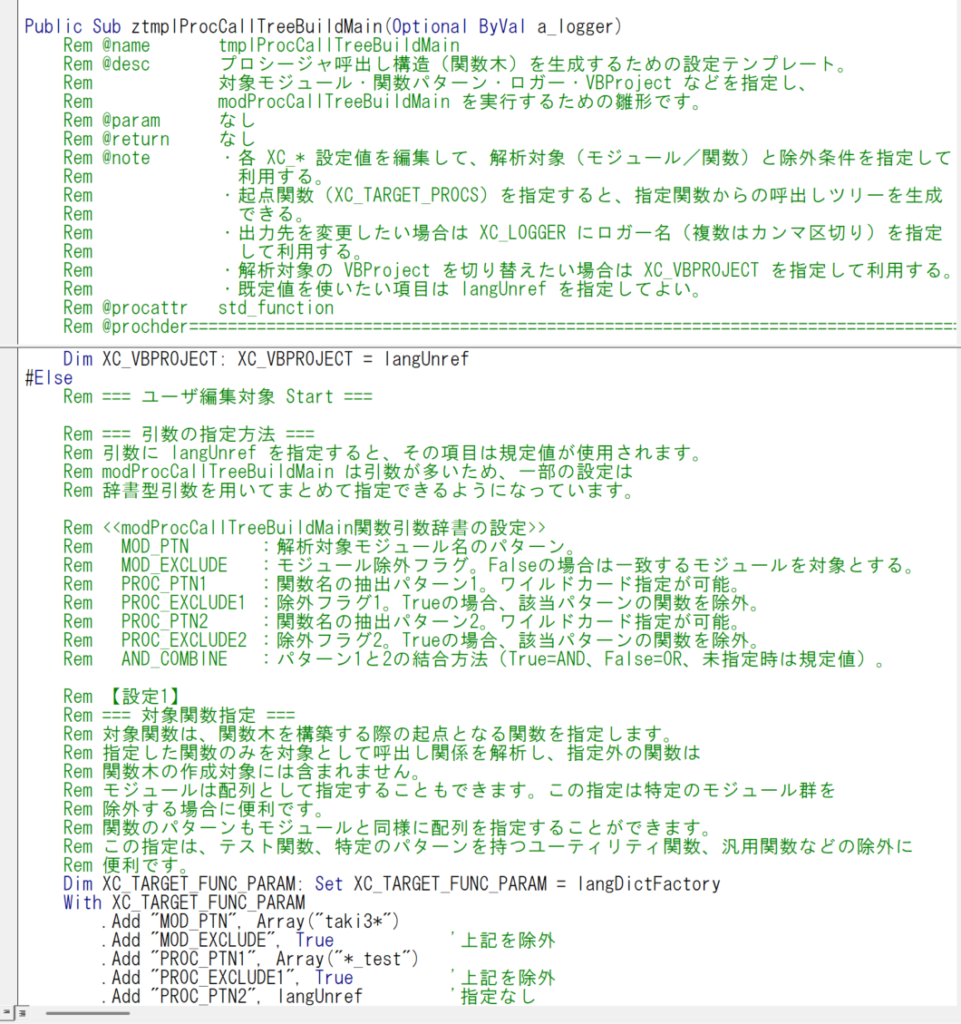
新規に追加されたモジュールを開くと、関数コールツリー生成のエントリとなる関数が作成されています。関数名はテンプレ実行時に自動で調整されるため、表示されている名称を確認し、必要があれば関数名を修正してください。
ここで行う作業は、次の点の確認と微調整です(必要に応じて、関数内の設定値を書き換えます)。この段階で、関数コールツリーを呼び出すテンプレートコードを一度読んでおくと、「ブラックボックスのツール」ではなく、自分の解析基盤として安心して使えるようになります。
ここまでで、滝Libを用いた関数コールツリー表示の準備は完了です。以降は、この関数を起点として、入力・出力・中間データを整理し、コールツリーとデータ流を重ねながら解析を進めていきます。
おすすめの書籍
プログラミングの手法について詳しい
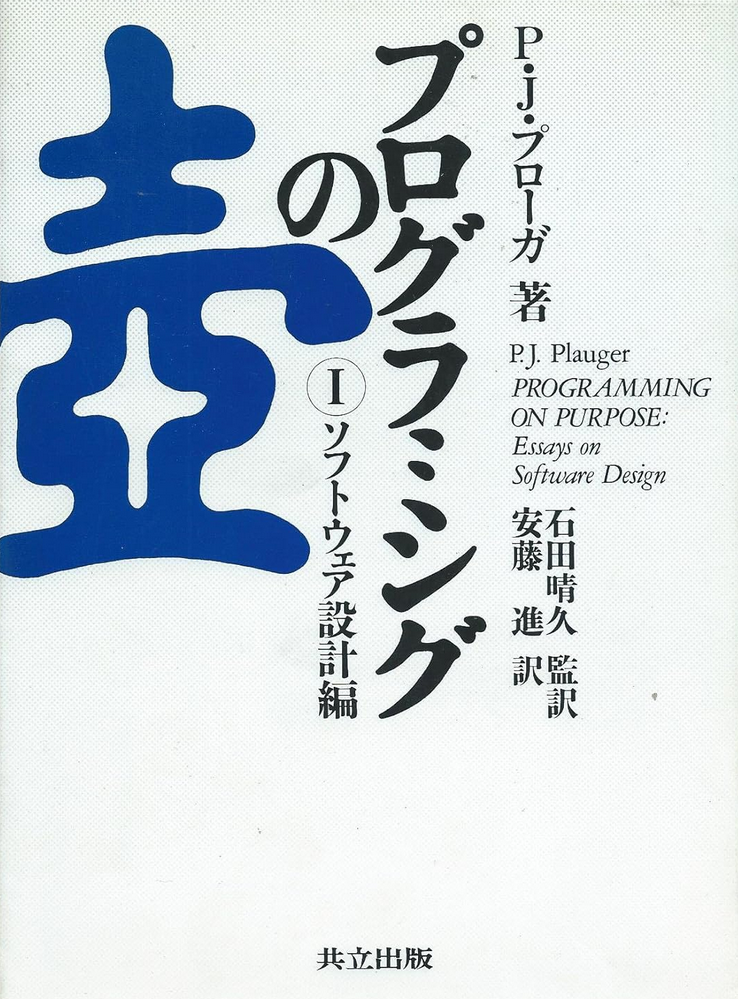
ジャクソン方について詳しい